这一章在做什么
第 11 章的批处理有个前提:输入有头有尾,读完了才出结果。现实里的数据一直在来,没有「到齐」的那一刻。这一章讲怎么对付这种数据。先看事件怎么传:传统消息代理读完就删,日志式代理把消息留在盘上、按偏移量读。再看数据库和流的关系:变更数据捕获和事件溯源,把数据库的每一次写变成一条可以重放的流。最后是流处理本身:时间和窗口、流的连接,以及永远跑不完的作业怎样做到「恰好一次」。
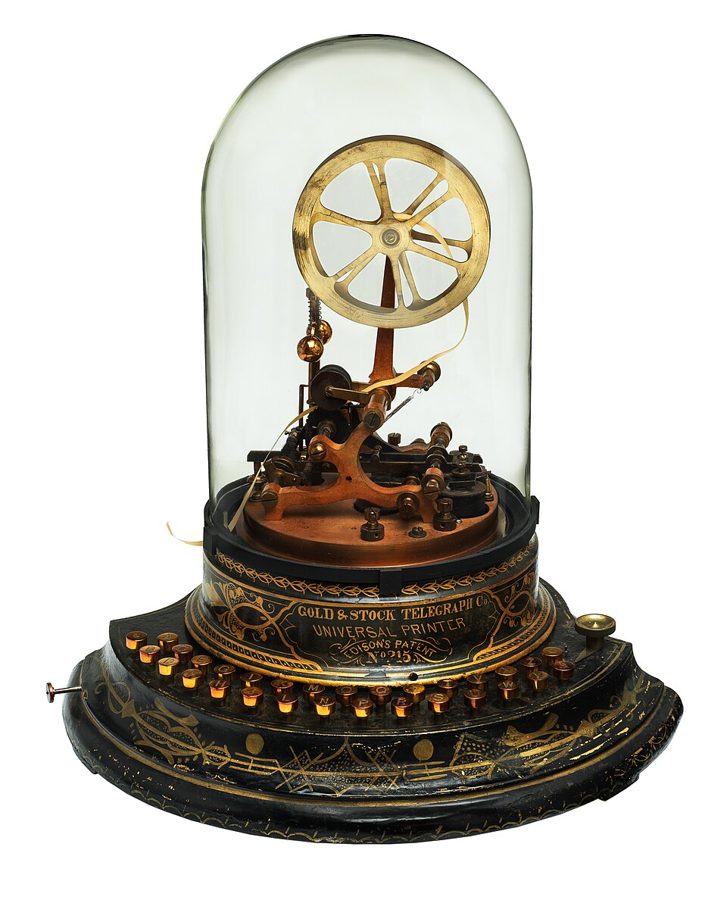
一台股票报价机(stock ticker),底座上写着 Gold & Stock Telegraph Co.、Universal Printer、Edison’s Patent。它是一种专用的电报接收机,线路上传来的行情一条接一条打在纸带上,照片里能看到纸带从机器里绕出来。这正是这一章说的「流」:数据随时间一点点到来,永远不会有「全部到齐」的时候。§1.1 提到,今天金融行情这类对延迟敏感的流,常用 UDP 组播直接发给接收方。Jaclyn Nash,公有领域,维基共享资源 读之前:先预测
这一章紧接着第 11 章:批处理的输入有界,流处理把这个前提拿掉。它把前面几章的零件重新串了一遍:第 4 章的日志结构和合并变成了消息代理的存储和日志压缩,第 6 章的复制日志变成了变更数据捕获,第 8 章的「恰好一次」和第 10 章的共享日志在这里换了个场合再出现。第 13 章接着这一章,讨论怎样用流把各种专门的数据系统接在一起。
一个平台按处理时间(流处理器自己的时钟)统计每分钟收到多少条充电桩心跳,平时稳定在每分钟 1200 条左右。某天一个地区的网关断网 3 分钟,那个地区的心跳(约占三分之一)全攒在网关里;网络恢复后,这批心跳在 20 秒内全部发了出来。监控图上会出现什么?
一条平线:心跳一条没丢,最后都到了,每分钟的数字不受影响
断网的 3 分钟掉到 800 左右,恢复后那一分钟冲到 2400 左右
断网的 3 分钟掉到 800 左右,然后回到 1200:补来的心跳会被算回它们原来那几分钟
断网的 3 分钟掉到零,然后回到 1200
一个消费者从日志式消息代理的一个分区里读订单事件,每处理完一批才把偏移量记下来一次。它最后一次记下的偏移量是 1000,之后又处理了 1000 到 1049 这 50 条(每条都往数据库里给对应商家的余额加钱),还没来得及记偏移量就崩溃了。同组的另一个消费者接手这个分区。会发生什么?
新消费者从 1050 接着读:代理知道上一个消费者实际处理到了哪
1000 到 1049 这 50 条丢了:上一个消费者已经把它们读走,日志里没有了
新消费者从 1000 开始读,这 50 条再处理一遍,这些商家的余额被加了两次
代理逐条记着确认,只重发那几条没确认的
数据永远不会到齐,处理也永远不会做完。批处理靠「失败了就整个重跑、半截输出扔掉」得到可靠的结果,这一招在流上用不了。那么事件该怎么传、怎么存、怎么算,才能让结果像没出过故障一样可信?
传统消息代理和日志式消息代理,「读一条消息」这件事有什么根本不同?这个不同带来了哪些好处和限制?§1.1 §1.2
应用同时写数据库和搜索索引,为什么没有任何报错,两边也会永远对不上?§2.1 §2.2
按事件发生的时间分窗口统计,什么时候才能宣布一个窗口「结束了」?§3.2
一个跑了几年的作业不能「失败了从头重跑」,它靠什么做到恰好一次的效果?§3.4
这一章的骨架
这一章分三大块:事件怎么传(§1),数据库和流是什么关系(§2),拿到流以后怎么算(§3)。三块之间的线索是「日志」:§1 的日志式代理、§2 的变更数据捕获、§3 的容错,用的都是一条有序、可以从头再读的日志。容易乱的是 §2 和 §3.2:§2 在 CDC、事件溯源、不可变性之间来回比较;§3.2 的几个时间概念要分清是谁的时钟。
流:输入永远不会到齐
传:事件怎么送到 §1
存:数据库也是流 §2
算:边来边处理 §3
直连,还是经过代理 §1.1
确认后删除的代理 §1.1
日志 + 偏移量 §1.2
慢消费者、重投、乱序
双写为什么会错 §2.1
变更数据捕获 §2.2
事件溯源、不可变 §2.3
真要删掉怎么办 §2.3
拿流做什么 §3.1
事件时间与窗口 §3.2
三种连接 §3.3
容错与恰好一次 §3.4
贯穿全章:一条有序、能从头再读的日志,把传、存、算接成一条线
本站画的全章结构。橙色两格是读的时候最容易卡住的地方,红色一格是 §2 要解决的那个问题。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
选哪种代理:每条处理很贵、要逐条并行、不在乎顺序,选确认后删除;吞吐高、每条处理快、顺序要紧,选日志式。
双写错在哪:并发写交错,两边收到的顺序相反(并发);一边写成功一边失败(容错,本质是原子提交)。
CDC 从哪起步:先拿一份对应日志某个偏移量的一致快照,再从那个偏移量接着应用;压缩过的主题从偏移量 0 读一遍就是全量。
删得掉吗:改写历史(Datomic 的 excision、Fossil 的 shunning),或加密粉碎;副本到处都是,只能做到「更难取回」。
窗口何时关:忽略迟到的事件(但要计数、报警),或者发一个更正,必要时撤回之前的结果。
连接用哪个时刻:不同流之间没有顺序保证;给被连接记录的每个版本一个唯一 ID,代价是不能做日志压缩。
恰好一次:离开框架的副作用(写外部数据库、发邮件);另两条路是框架内部的原子提交,和幂等写入。
分节地图
全章约 1.8 万词(不算代码和图注),建议分四次读。第一次讲消息怎么传,节奏平稳;第二次是全章的思想重心,数据库和流其实是一回事;第三次换到流处理,§3.2 讲时间的那一节最需要慢读;第四次的连接和容错,要用到前面所有的概念。
第一次坐下§0–§1.2 · 约 5200 词 · 从批处理到消息代理
In Chapter 11 we discussed…约 400 词 开篇 批处理的输入有界,现实的数据无界。流是什么,这一章分哪三步走。 Transmitting Event Streams约 500 词 传送事件流 事件、生产者、消费者、主题这几个词;为什么轮询数据库不够用。 Messaging Systems约 2100 词 消息系统 两个问题区分各种系统:发得比收得快怎么办,节点崩溃丢不丢。再看直连、代理、确认和重投。 Log-Based Message Brokers约 2100 词 基于日志的消息代理 把消息存进分区的日志,按偏移量读。抓住它和传统代理在并行、顺序、重放上的差别。 第二次坐下§2–§2.3 · 约 5100 词 · 数据库和流是一回事
Databases and Streams约 400 词 数据库与流 反过来,把流的想法用到数据库上:复制日志本来就是一条写事件的流。 Keeping Systems in Sync约 600 词 让多个系统保持同步 同一份数据存在好几个系统里,靠双写同步会出什么事。 Change Data Capture约 2200 词 变更数据捕获 把数据库的变更日志变成公开的流:初始快照、日志压缩、和事件溯源的对比,加一个讲模式的方框。 State, Streams, and Immutability约 2000 词 状态、流与不可变性 可变的状态和不可变的事件日志是什么关系;不可变的好处,和删不掉的麻烦。 第三次坐下§3–§3.2 · 约 3900 词 · 流处理的用途和时间
Processing Streams约 500 词 处理流 拿到流能做的三件事,以及流处理和批处理唯一关键的不同。 Uses of Stream Processing约 1700 词 流处理的用途 复杂事件处理、流分析、维护物化视图、流上搜索,以及为什么 actor 不算流处理。 Reasoning About Time约 1700 词 关于时间的推理 事件时间和处理时间、迟到的事件、该信谁的时钟、四种窗口。全章最该慢读的一节。 第四次坐下§3.3–§4 · 约 3700 词 · 连接、容错和小结
Stream Joins约 1700 词 流的连接 流和流、流和表、表和表三种连接,最后落到「跟哪个时刻的状态连接」。 Fault Tolerance约 1300 词 容错 永远跑不完的作业怎么做到恰好一次:微批、检查点、原子提交、幂等、重建状态。 Summary约 800 词 小结 全章回顾。先自己回忆一遍再读它。
先用中文过一遍
两种消息代理:读完就删,还是读完只挪一下指针
生产者把事件交给代理,代理再交给消费者,这样双方不用同时在线。传统的消息代理(RabbitMQ 这类,遵循 AMQP 或 JMS 标准)像一个任务队列:每条消息单独派给某个消费者,消费者处理完回一个确认,代理就把它删掉;超时没收到确认,就把这条消息重投给别人。这对「每条都很贵、谁处理都行」的任务很合适,代价是消息一旦确认就没了,新来的消费者看不到过去的消息。
日志式代理(Kafka 这类)换了个思路:消息按顺序追加到日志里,日志按分区切开放在多台机器上,每条消息在分区里有一个递增的编号,叫偏移量。消费者读消息不删消息,只记住自己读到了哪个偏移量。好比一群人读同一本账簿,各自夹各自的书签:多个消费者组互不影响,想重新处理昨天的数据,把书签往回挪就行。代价是并行度按分区算:一个分区在一个组里只交给一个消费者,按顺序一条条处理。
确认后删除(AMQP / JMS 式)
日志式(Kafka 式)
#43
#44
#45
#46
消费者 A
消费者 B
每条订单消息单独派给一个消费者
处理完回一个确认,代理就删掉它
超时没确认,就重投给别的消费者
新来的消费者看不到已经删掉的消息
分区 0
0
1
2
3
4
5
6
7
▲乙
▲甲
分区 1
0
1
2
3
4
5
← 追加
▲乙
▲甲
甲=库存服务,乙=数仓导入,各记各的偏移量
读消息不删消息,日志只往后追加
一个分区在组里只交给一个消费者
旧消息按段过期删除,和读没读过无关
本站画的示意图,数据是编的。左边的消费者 A、B 在抢同一个队列里的活;右边的甲、乙是两个独立的消费者组,三角指向它们下一条要读的消息。
让数据库变成一条流:变更数据捕获和事件溯源
一个应用的数据常常要同时放在数据库、缓存、搜索索引和数据仓库里。最直接的同步办法是双写:应用改完数据库,再自己去改索引、清缓存。问题是两个请求同时改同一条记录时,两个系统可能以相反的顺序收到它们,最后各自留下不同的值,而且没有任何报错;另外,一边写成功、一边失败,也会对不上。
变更数据捕获(CDC)的办法是:应用只写数据库,数据库按自己定下的提交顺序把变更写进复制日志,再把这份日志当成一条公开的流,索引、缓存、数仓都只是这条流的消费者。这其实就是第 6 章的主从复制:数据库当主,别的系统当从。事件溯源(第 3 章讲过)走得更远:应用一开始就不写「当前状态」,只把「发生了什么」作为不可变的事件追加进日志,状态全部从日志算出来。
双写:应用自己去写两处
数据库收到的顺序
搜索索引收到的顺序
① 运营甲:#8812 改成 39 元
② 运营乙:#8812 改成 45 元
① 运营乙:#8812 改成 45 元
② 运营甲:#8812 改成 39 元(晚到)
最后是 45 元
最后是 39 元,从此对不上
两边都没报错。另一种坏法:一边写成功,一边写失败。
变更数据捕获:只写数据库,别的系统跟着它的日志走
应用
数据库
8812=39
8812=45
变更日志(按提交顺序)
搜索索引:45
缓存:45
顺序由数据库一处说了算,下游按同样的顺序应用,结果就一样
本站画的示意图,商品号和价格是编的。书里用一个抽象的键和两个值说明同一件事。
这一节背后有一个更大的想法:可变的状态和不可变的事件日志,是同一样东西的两种样子。仓库的库存是所有入库、出库单算出来的,会员积分是每一次消费和兑换累加出来的。日志存下来,状态随时能重算;数据库存的「当前值」,不过是日志末尾的一份缓存。代价也在这里:日志会一直长,真要删掉某个人的数据,在不可变的世界里很难。
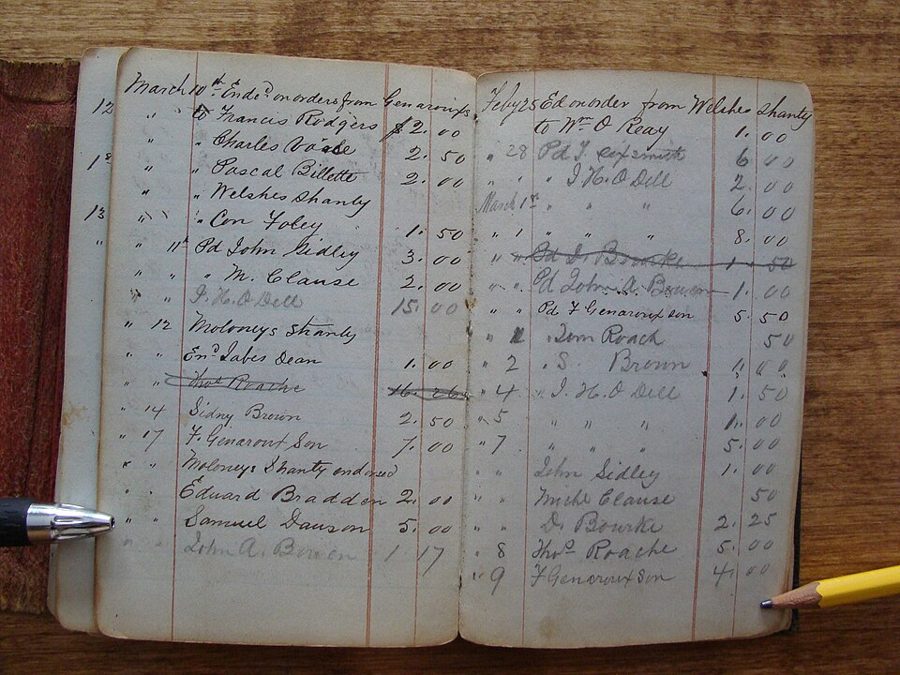
Denis Nealon 的账本兼日记里的两页,记的是 1870 年 2 月到 3 月几处营地(shanty)的账,与本书无关。账本是很老的一种「只追加的日志」:一笔一笔往下记,余额是加出来的。有几行被划掉了,但原来写的字还看得清。§2.3 说会计更讲究:记错了不涂改,而是再记一笔冲正。Deseronto Archives,无已知版权限制,维基共享资源 事件时间、处理时间和窗口
流分析常常要「按分钟统计」。可「这一分钟」有两种算法:按事件发生的时间(事件时间),还是按流处理器看到它的时间(处理时间)?平时两者只差几毫秒,可一旦有积压、断网、重启,处理时间就会把一批旧事件当成「刚刚发生」。按事件时间算才对,但新的麻烦来了:你永远说不准一个窗口的事件到齐了没有,总可能有一条还在路上,这就是迟到的事件(straggler)。只能等一会儿再宣布窗口结束;等得越久越完整,结果也出得越晚。
事件时间(发生)
12:00
窗口
12:01
12:02
12:03
12:04
12:00
12:01
①
12:02
12:03
12:04
处理时间(到达)
① 12:01:30 见过的最大事件时间是 12:01:24,等 20 秒,水位线到 12:01:04
② 水位线越过 12:01,12:00 这个窗口(上方浅色段)就输出结果
③ 之后才到的 12:00:48(蓝线)和断网补发的 12:00:36(红线):丢掉或发更正
本站画的示意图。每条线连着同一个事件的发生时刻和到达时刻;线越斜,路上走得越久,两条线交叉就是乱序。「水位线」是下面模拟器用的规则。这一节没有用这个词;书里只在 §2.2 讲 Debezium 的快照时提到 watermarking,意思不同。
窗口怎么划也有几种。滚动窗口首尾相接、不重叠,每个事件只属于一个窗口;跳跃窗口长度固定但互相重叠,统计更平滑;滑动窗口按事件彼此之间的距离来定,不看固定的边界;会话窗口没有固定长度,同一个用户隔了一段时间没动静,会话就结束。
12:00
12:02
12:04
12:06
事件
滚动
3 个
1 个
3 个
跳跃
每个窗口长 2 分钟,每分钟开一个,互相重叠
滑动
往回 2 分钟
相隔不到 2 分钟的事件落在同一个窗口里
会话
会话 1
空闲超过 1 分钟就结束
会话 2
本站画的示意图,七个事件是随便放的。同一组事件,按四种窗口切出来的结果完全不同;选哪种取决于你要回答什么问题。
恰好一次:输出要么全算数,要么全作废
批处理的容错很简单:任务失败了,扔掉它写了一半的输出,换台机器从头再跑,最终结果和没失败一样,好像每条记录恰好处理了一次。流处理做不到「等任务做完再公开输出」,因为它永远做不完。办法是把流切成小段:要么每段当一个小批处理(微批),要么定期给状态拍一张检查点,崩溃后从最近的检查点重来,把之后的输出作废。
这只管得住框架内部。输出一旦离开框架,写进外部数据库、发了邮件,就收不回来了,重来一次就会做两遍。剩下两条路:一是让「处理这条消息」的所有后果(输出、状态变化、移动偏移量)在一个事务里一起提交;二是把写操作做成幂等的,做两遍和做一遍效果一样,比如写入时带上触发它的那条消息的偏移量,重复的就能认出来。
这一章点名的系统
Apache Kafka 日志式消息代理 按分区存日志,消费者用偏移量记进度,支持日志压缩。书里反复拿它举例。
RabbitMQ 消息代理 书里列出的 AMQP / JMS 一类传统代理之一,确认后删除消息。
Debezium CDC 工具 开源项目,接到 MySQL、PostgreSQL 等数据库的复制日志上,用统一的事件格式吐出变更。
Apache Flink 流处理框架 定期给算子状态做检查点,写到持久存储上,崩溃后从最近的检查点重来。
Spark Streaming 流处理框架 用微批:把流切成一秒左右的小批,每批当一次小的批处理。
Kafka Streams 流处理库 把状态的变更发到一个开启了日志压缩的主题里,用来复制和恢复状态。
Materialize 数据库 书里列出的增量视图维护(IVM)数据库之一,同列的还有 RisingWave、ClickHouse、Feldera。
Esper 复杂事件处理 书里列出的 CEP 实现之一,按事先定好的规则在事件流里找模式。
Elasticsearch 搜索引擎 它的 percolator 功能先存查询、再拿新文档去匹配,书里举它做流上搜索。
Druid 分析数据库 书里的例子:直接从 Kafka 摄入事件,在同一份日志上建自己的视图。
英文 中文 一句话 message broker 消息代理 专门为消息流优化的服务器,生产者写进去,它再投给消费者(§1.1)。 backpressure 背压 接收方处理不过来时,让发送方停下来等(§1.1)。 acknowledgment 确认 消费者告诉代理「这条处理完了」,代理才把它移出队列(§1.1)。 dead letter queue (DLQ) 死信队列 反复处理失败的消息被挪进去,别卡住后面的消息(§1.1)。 consumer group 消费者组 组内分摊消息,不同组各收一份(§1.1、§1.2)。 log-based message broker 日志式消息代理 把消息追加进分区的日志,读不删除,按偏移量读(§1.2)。 offset 偏移量 消息在分区里的递增编号,消费者用它记进度(§1.2)。 change data capture (CDC) 变更数据捕获 把写进数据库的每一个变更取出来,作为流交给别的系统(§2.2)。 log compaction 日志压缩 同一个键只留最新的一条,日志大小只取决于当前数据(§2.2)。 outbox pattern 发件箱模式 专门开几张对外的表给 CDC 读,内部的表随便改(§2.2 方框)。 event sourcing 事件溯源 只记不可变的事件,状态全部从事件日志推出来(§2.2、§2.3)。 event time / processing time 事件时间 / 处理时间 事件发生的时刻,和流处理器处理它的时刻(§3.2)。 straggler 迟到的事件 窗口已经宣布结束以后才到的事件(§3.2)。 exactly-once semantics 恰好一次语义 可能重试多次,但看到的效果和每条只处理一次一样(§3.4)。 idempotence 幂等 做多次和做一次效果相同(§3.4)。
动手:模拟器
书里提到一种特殊消息,告诉下游「从现在起不会再有早于某个时刻的事件」,可以用它来触发窗口。很多流处理框架(比如 Flink)把这个时刻叫作水位线(watermark)。下面的模拟器用一种常见的算法:水位线 = 目前见过的最大事件时间 − 等待时间;水位线越过窗口的结束时刻,窗口就输出;之后才到的、属于这个窗口的事件就是迟到的。
先猜:等待时间为 0 时,32 个事件里会丢掉几个?等 30 秒呢?要把断网网关补发的事件全部收进来,得等多久?代价是什么?猜好了再动手。
模拟器 事件时间、窗口与迟到的事件 一个门店系统按事件时间统计每分钟的订单数。事件按到达的先后一个个进来,格子里写的是事件发生的时间(1:08 就是 12:01:08)。从「下一个事件」开始,看水位线怎么推进、窗口什么时候输出、谁被丢掉。绿格子算进了已输出的窗口,红格子被丢掉,蓝格子是窗口输出后才到、发了更正的。
下一个事件
再来 5 个
全部放完
重置
等待时间 0 秒 10 秒 20 秒 30 秒 60 秒 180 秒
窗口 1 分钟 2 分钟
迟到的事件 丢掉 发更正
点「下一个事件」,一个一个看。
等待时间 0 秒、窗口 1 分钟、迟到的丢掉,点「全部放完」,数一数丢了几个;改成 30 秒再看。丢掉的少了,「窗口结束后平均多久才输出」变成了多少?
重置,等待时间 0 秒,一个个点到第 7 个事件(发生在 0:52,路上走了 25 秒),它为什么被丢掉?换成 10 秒,同一个事件为什么就收进去了?
断网网关补发的三个事件,路上走了一分多钟到两分半钟。等待时间要调到多少才一个不丢?这时一共输出了几个窗口?再把「迟到的事件」换成「发更正」,比较两种做法的输出。
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(CDC、offset、straggler 这类)不在这里,在上面的术语表里。
§0 In Chapter 11 we discussed…
not an option
… starting the output early is not an option.
根本不能这么做
option 是「可走的路」。is not an option 说的是行不通,不是「不是一个选项」。
go out of business
… Unless you go out of business, this …
倒闭、关门
作者的玩笑:除非公司倒闭,否则数据不会停。
counterpart
… the unbounded, incrementally processed counterpart to …
对应物、另一面
§1 Transmitting Event Streams
self-contained
… a small, self-contained, immutable object …
自成一体的(不靠别处的信息就能读懂)
afterthought
… have been somewhat of an afterthought …
事后才补上的东西
设计时没当回事、后来才加上的功能。somewhat of a 是「有点算是」。
§1.1 Messaging Systems
afford to
… you can afford to sometimes lose …
承受得起(某种损失)
afford 不只是「花得起钱」,can afford to lose 是「丢了也没关系」。
break down
… this approach may break down if …
(方法)失灵、行不通
说的是办法不管用了,不是机器坏了。§3.2 开头的 it breaks down with 也是这个意思。
come and go
… tolerate clients that come and go …
来来去去(连上、断开、崩溃)
a fraction of a second
… often within a fraction of a second, …
不到一秒
spill to disk
… perhaps spilling messages to disk if …
(内存放不下)溢写到磁盘
spill 本义是洒出来。数据库和计算引擎里常说内存不够时 spill 到盘上。
tune in
… each “tune in” to the same …
收听、调到同一个频道
收音机的说法:几个消费者各自收听同一路广播,互不影响。
make progress
… no further progress can be made.
(处理)往前推进
分布式系统里 progress 指能不能继续往下处理,no progress 就是卡死在原地。
§1.2 Log-Based Message Brokers
leave no trace
… operation that leaves no permanent trace.
不留下(永久的)痕迹
mindset
… inherited this transient messaging mindset.
思维方式、思路
destructive
… receiving a message is destructive if …
(读一次就)毁掉原数据的
不是「搞破坏」,是说读完消息就被删了,没法再读第二次。
trivially
… The log-based approach trivially supports fan-out …
不费吹灰之力地、天然就
trivial 在技术英文里常是「不费事」,不是「琐碎」。
hold up
… it holds up the processing of …
拖住、耽搁
不是「举起」或「撑住」。hold-up 当名词是「延误」。
blurred
… two architectures is being blurred since …
(界线)变得模糊
bookkeeping
… The reduced bookkeeping overhead and …
(为了跟踪进度的)记录工作
本义记账。这里指代理要为每条消息记确认状态的那些开销。
back-of-the-envelope
… Let’s do a back-of-the-envelope calculation.
粗略估算
在信封背面随手算一算,只求数量级对。
at the time of writing
… At the time of writing, a …
写这本书的时候
提醒读者:后面的数字会过时。
fall behind
… If a consumer falls so far behind …
落后
manipulate
… it can easily be manipulated if necessary …
调整、改动
技术英文里没有「操纵」的贬义,就是按需要去改它。
§2 Databases and Streams
go as far as
… have to go as far as adopting …
走到……那一步
don’t have to go as far as:不必做得那么彻底。
run deeper than
… runs deeper than just the physical storage …
比……更深一层
run 在这里是「延伸到」,联系不止于表面那一点。
§2.1 Keeping Systems in Sync
nontrivial
… most nontrivial applications need to combine …
有一定规模的、不是玩具的
nontrivial 不是「重要的」,是「不是随手写写的」。
unlucky timing
… Because of unlucky timing, the requests …
时机不巧
§2.2 Change Data Capture
surface
… and surface the changes in a standard …
(动词)把……拿出来、呈现出来
本义是浮出水面:把藏在复制日志里的变更翻出来给别人用。
retrofitted
… the retrofitted and reverse-engineered CDC efforts …
事后加装的
sidestep
… Cassandra sidesteps this issue by exposing …
绕开(问题)
不是解决了,是躲开了:把难题留给读日志的人。
at will
… updating and deleting records at will.
随意、想改就改
customer-facing
… can cause a customer-facing outage.
用户直接看得到的
as they see fit
… schemas as they see fit while …
按自己认为合适的方式
see 在这里是「认为」,fit 是「合适」。
§2.3 State, Streams, and Immutability
two sides of the same coin
… two sides of the same coin. …
一枚硬币的两面
看上去对立,其实是同一样东西。
mathematically inclined
… If you are mathematically inclined, you …
喜欢用数学的方式想问题
compensate for
… another transaction that compensates for the mistake …
抵消、弥补
decide against
… but then decided against it.
决定不要了
against 不是「反对」某人,是最后没选它。
fallacy
… is based on the fallacy that …
错误的假定
by construction
… By construction, it processes only a …
从构造上就保证了
数学里的说法:不用额外检查,结构本身就决定了它只能这样。
churn
… the amount of churn in the dataset.
(数据)变动的频繁程度
本义搅动。用户流失也叫 churn,这里说的是数据被反复改写、删除。
prohibitively
… history may grow prohibitively large, …
大到承受不起
move the problem around
… this only moves the problem around; …
只是把问题挪了个地方
没有解决,只是换了个地方出现:数据不可变了,密钥库却得可变。
up front
… you have to decide up front which …
事先、一开始就
unwieldy
… would get too unwieldy, as …
臃肿难管
§3 Processing Streams
viable
… may not be a viable option.
可行的
§3.1 Uses of Stream Processing
geared toward
… especially geared toward the kind of …
专门面向
gear 是齿轮,「调好齿轮去配合」某种用途。
standing query
… any of its standing queries.
长期挂着的查询
standing 是「常设的」,不是「站着的」;standing order 是长期委托。
as a general rule
… but as a general rule, stream …
大体上说
run counter to
… forever runs counter to the assumptions of …
和……相抵触
bespoke
… Bespoke solutions work in a few cases, …
量身定制的
turn something on its head
… turns the processing on its head.
把……整个颠倒过来
that said
… That said, there is some crossover …
话虽如此
前面刚下了结论,接着要补一句例外。
farm out
… to be farmed out to a set …
分派出去
和农场无关,是把活儿分给别人做。
§3.2 Reasoning About Time
crunch through
… rapidly crunch through a large collection …
一口气算完(大量数据)
negligibly
… event processing is negligibly short.
(短)到可以忽略
cope with
… able to cope with such discontinuities, …
应付
time has moved on
… and time has moved on; now …
时间已经往前走了
move on 是「往下走、翻篇」:新到的事件都已经是后面几分钟的了。
retract
… need to retract the previous output.
撤回
round down
… rounding it down to the nearest minute …
向下取整
§3.3 Stream Joins
augmented with
… has been augmented with profile information …
补充了、加上了
the beginning of time
… reaches back to the “beginning of time” …
时间的起点(也就是全部历史)
夸张说法,指从有数据的第一刻起,窗口无限长。
put another way
… Put another way: if state changes …
换句话说
§3.4 Fault Tolerance
within the confines of
… Within the confines of the stream …
在……的范围之内
confines 是边界、围墙:出了框架这道墙,它就管不着了。
caveat
… Despite all those caveats, idempotent …
附加条件、要提防的前提
caveat 是「但书」:用之前先看清的那几条限制。
universally ideal
… No solution is universally ideal for …
在哪儿都最好
§4 Summary
from scratch
… by starting from scratch and consuming …
从零开始
scratch 是赛跑时地上划的起跑线。
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
答案是第二项(§3.2)。按处理时间开窗,一条心跳算进哪一分钟,看的是它什么时候到,不是什么时候发生。断网那 3 分钟里,那个地区的心跳一条也没到,每分钟只剩约 800;恢复后的那一分钟,平时的 1200 加上积压的 3×400,冲到约 2400。实际的心跳频率一直很平稳,图上的坑和尖峰都是统计方式造出来的。书里举的是流处理器重启、积压一批事件的情况,原理一样。想一想:换成按事件时间开窗、等待时间 1 分钟,那 3 分钟的数字会变成什么样?补来的心跳又会怎样?
答案是第三项(§1.2,§3.4)。日志式代理不逐条记确认,只定期记下每个消费者的偏移量;接手的消费者从最后记下的 1000 开始读,1000 到 1049 会再处理一遍。读消息不会删消息,所以也不会丢。「给余额加钱」不是幂等操作,做两遍就多加一次。§3.4 给的办法之一,是把触发这次写入的消息偏移量和余额一起存进数据库,重来时一看就知道这条已经处理过。想一想:如果这 50 条处理的是「把订单状态设成已发货」,重复处理还有害吗?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
消费者加了一倍,积压为什么不降?§1.2
场景:订单事件写进一个日志式代理的主题,主题有 4 个分区,按商家 ID 分区。大促时积压越来越多,团队把消费者组从 4 个实例扩到 8 个,积压一点没降。
继续扩到 16 个实例,总会降下来 增加主题的分区数;同一商家的事件仍按商家 ID 落在同一个分区 每个实例开大线程池,一个分区里的消息多线程并发处理 改成每处理一条就提交一次偏移量
日志式代理按分区分活:一个分区在一个组里只交给一个消费者,所以并行度的上限就是分区数,多出来的 4 个实例在闲着,再加也一样。书里的建议是一个分区单线程处理,要更多并行就加分区。线程池能提速,但偏移量的管理会变复杂,分区内的顺序也保不住。逐条提交偏移量只会增加开销。
搜索结果的价格为什么和详情页对不上?§2.1 §2.2
场景:商品服务改价格时先写 MySQL,再调用接口写 Elasticsearch。偶尔有商品在搜索结果里显示的价格和详情页不同,而且一直不自己恢复。查遍日志,两边的写入都返回了成功。
给写 Elasticsearch 加上失败重试 调换顺序:先写 Elasticsearch,再写 MySQL 给 Elasticsearch 的写请求设一个更短的超时 应用不再写 Elasticsearch,改为从 MySQL 的变更日志按提交顺序同步过去
两边都成功、却永久不一致,是双写的竞态:两次改价并发,两个系统收到的顺序相反。重试和超时针对的是写失败,这里没有失败;换个顺序,竞态照样存在。让数据库一处决定顺序,再用 CDC 按这个顺序同步,下游就和数据库一致了。
队列为什么卡住了?怎么办?§1.1
场景:一个上游服务发版后,发出了一条少了必填字段的消息。消费者每次处理它都崩溃重启,代理没收到确认就把它重投给下一个消费者,后面的消息全堵着不动。
处理失败若干次后把它挪进死信队列,并对死信队列设告警 关掉确认机制,代理一投出去就删掉 多加几个消费者分担 让代理严格按顺序投递
书里讲过这个场景,常被叫作「毒消息」(poison message):没有确认就重投,重投又让下一个消费者崩溃,无限循环;代理越讲究顺序,后面的消息越动不了。死信队列把它挪开,让队列继续走,再由人决定丢掉、修好重发还是改消费者代码。关掉确认会在正常崩溃时丢消息;加消费者只会让更多消费者崩溃。
看板既要快,又要准,迟到的事件怎么处理?§3.2
场景:景区按事件时间每 5 分钟统计一次入园人数。部分闸机走 4G 上报,偶尔晚到几分钟。运营要求每个 5 分钟过去后尽快出数,财务月底对账要求数字准确。
改用处理时间开窗,就不会有迟到的事件了 每个窗口等 1 小时再输出,保证收齐 等待时间设短一点,先出数;迟到的事件到了就发更正,同时统计迟到了多少 迟到的事件一律丢掉,反正比例不大
书里给了两条路:忽略迟到的事件(记个数、多了就报警),或者发更正。这里两头都要,发更正最合适:看板先拿到一个及时的数,月底对账用更正后的数。按处理时间开窗只是把迟到的人算进了错误的时段;等 1 小时,看板就不及时了;一律丢掉,对账就不准。
恢复之后,为什么有用户收到两条短信?§3.4
场景:一个 Flink 作业每处理一笔订单,就调用短信服务通知用户。作业崩溃后从最近的检查点恢复,有一部分用户收到了两条一样的短信。
把检查点间隔从 1 分钟缩短到 5 秒 调短信服务时带上订单号,让它按订单号去重 改用微批处理 关掉检查点,崩溃了就从头处理
检查点只能作废框架内部的输出,短信一旦发出去就收不回;从检查点重来,检查点之后处理过的订单又会发一遍。缩短间隔只能减少重复,不能消灭;微批有同样的问题;从头处理重复得更多。带上订单号让下游去重,等于把发短信变成幂等操作。
和本站其他书对照
确认、超时和重传 OSTEP 第 48 章 §1.1 的确认和重投,是可靠通信的老办法搬到了消息代理上。OSTEP 那一章从头讲了确认、超时重传,以及为什么重传会造成重复、要靠序列号认出来,正好对上这一章「没收到确认不代表没处理完」那个括号。
去那一页 → 幂等操作 OSTEP 第 49 章 §3.4 靠幂等实现恰好一次。NFS 的客户端遇到任何失败都直接重试,前提是大多数请求是幂等的:带着确切偏移量的写,做几遍都一样。这和这一章「写入时带上消息偏移量」是同一个思路。
去那一页 →
值得停下来的句子
mutable state and an append-only log of immutable events do not contradict each other; they are two sides of the same coin.— §2.3。本站译:可变的状态和只追加、由不可变事件组成的日志并不矛盾,它们是一枚硬币的两面。
这句话是全章的转折点。前半章把日志当成传消息的管道,到这里日志变成了数据本身:数据库存的当前状态,只是把日志从头算到尾的结果。有了这个视角,CDC、事件溯源、日志压缩、用变更日志做流和表的连接、从日志重建状态,都成了同一件事的不同用法。第 13 章的「拆开数据库」也从这里出发。
you can never be sure whether you have received all the events for a particular window or some are still to come.— §3.2。本站译:你永远无法确定,一个窗口的事件是已经全部收到了,还是有一些还在路上。
批处理没有这个问题:文件读完了,数据就齐了。流处理的很多设计,从等待时间、更正、撤回,到给事件打三个时间戳,都是在跟这句话讨价还价。它没有正确答案,只有取舍:等得越久越完整,结果出得越晚。上面的模拟器就是让你亲手摸一摸这个取舍。
检查一下理解
1.(§1.1)生产者发得比消费者处理得快,系统有哪三种选择?日志式代理属于哪一种? 丢掉、缓冲、背压。日志式代理是一种缓冲,只是缓冲区在磁盘上,又大又固定;消费者落后太多,需要的消息已经过期删除,它就会错过这些消息。
2.(§1.1)负载均衡加上重投,为什么会打乱消息的顺序? 一个消费者处理到一半崩溃,那条消息没确认,代理把它重投给另一个已经在处理后面消息的消费者,后面的消息就先处理完了。想保序,就给每个消费者一个单独的队列,不用负载均衡。
3.(§1.2)日志式代理为什么不用逐条记录确认?代价是什么? 一个分区按顺序消费,偏移量之前的都处理过,之后的都没处理,代理只要定期记下偏移量。代价是消费者崩溃后从上次记下的位置重来,中间那些消息会被处理两遍。
4.(§2.2)CDC 的事件可以做日志压缩,事件溯源的事件为什么通常不行? CDC 的更新事件带着整条记录的新值,同一个主键只看最后一条就够。事件溯源记录的是用户的意图,后面的事件不覆盖前面的,要全部历史才能算出当前状态。
5.(§2.2 方框)发件箱模式看上去就是双写,为什么没有双写的问题? 两次写都在同一个数据库里,可以放进同一个事务,要么都成功要么都失败。CDC 只读发件箱表,内部表的模式可以随便改。代价是要维护两套模式之间的转换,数据库也要多写一份数据。
6.(§3.1)复杂事件处理里,「查询」和「数据」的角色怎样和普通数据库反过来了? 普通数据库长期存数据,查询来了查完就忘。CEP 长期存查询,每来一个事件就检查它是否让某个常设的查询匹配上了,匹配上了就发出一个「复杂事件」。
7.(§3.3)流和表的连接,为什么说本质上也是两条流的连接? 流处理器在本地放一份表的副本,订阅这张表的变更日志来更新它。于是表那一边也是一条流,只是它的窗口一直延伸到最早的数据,新版本覆盖旧版本。
8.(§3.4)靠幂等写入做到恰好一次,有哪几个前提? 重启后要按同样的顺序重放同样的消息(日志式代理做得到),处理要是确定性的,没有别的节点同时改同一个值;从一个节点切到另一个节点时,可能还要用防护令牌挡住假死的旧节点。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 流处理是永远不结束的批处理;一条有序、能重放的日志,把消息、数据库和计算接在一起。
读完就没了 传统代理确认后删除消息,新来的消费者看不到过去;日志式代理读只是挪偏移量,昨天的数据可以再处理一遍。
§1.2 分区数就是并行度 一个分区在组里只交给一个消费者。实例比分区多,多出来的就闲着;要更快,先加分区。
§1.2 信封背面算一算 书里粗算:一块大硬盘以最快速度写,也要大约 22 小时才写满。所以磁盘上的日志至少能缓冲这么久,实际常有几天到几周。
§1.2 没有报错的不一致 双写时两个并发修改在两个系统里顺序相反,两边都成功,却从此对不上。让数据库一处定顺序,下游跟着它的变更日志走。
§2.1 状态是日志的缓存 库存是入库出库单算出来的,积分是消费和兑换累加出来的。存下日志,状态随时能重建;真要删数据时,麻烦也在这里。
§2.3 窗口永远说不准齐没齐 按事件时间统计,总可能有一条还在路上。要么丢掉迟到的并计数,要么发更正;等得越久越完整,也越晚。
§3.2 恰好一次是效果上的一次 记录可能处理好几遍,只要输出看起来像一次。框架外的副作用收不回,得靠事务或幂等。
§3.4