这一章在做什么
复制让数据有了好几份。第 6 章把由此带来的不一致交给应用去处理,这一章走另一条路:让系统看起来只有一份数据。先给「强一致」一个精确的定义,叫线性一致性,看哪几种复制方式做得到、要付出多少延迟;再看分布式的发号器和逻辑时钟为什么只能保证因果;最后落到共识:选主、锁、唯一约束、共享日志、原子提交,其实是同一个问题。代价是每一步都要多数节点点头。
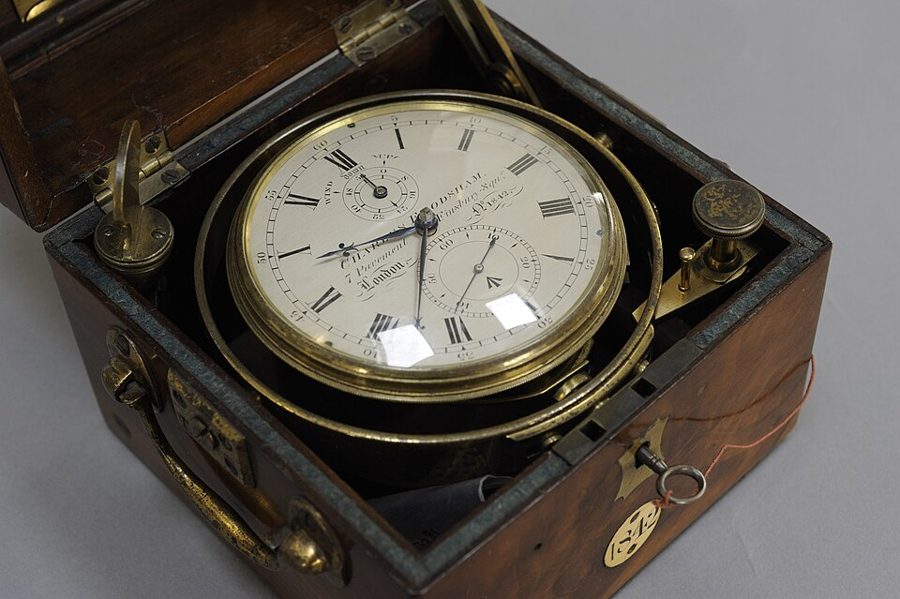
伦敦制表商 Charles Frodsham 做的一只航海天文钟,装在箱子里。这一章的题词引了一句航海老话:出海别带两只钟,要么带一只,要么带三只。两只钟走得不一样时,你不知道该信哪只;有三只,就能看哪两只说得一样。这正是 §3 里「多数派」的道理。Charles Frodsham,CC BY-SA 4.0,维基共享资源 读之前:先预测
这一章是「分布到多台机器」这一块的收口,前面三章留下的问题都在这里回收:第 6 章的复制延迟、多主和无主复制的冲突、法定人数;第 8 章的比较并设置(CAS)和两阶段提交里那个单点的协调者;第 9 章的租约、防护令牌、不可靠的时钟和系统模型。往后看,第 12 章的流处理会用到这里的共享日志,第 13 章会讨论怎样在不要线性一致的情况下仍然做对。
一个无主复制(Dynamo 风格)的键值存储,n = 3、w = 3、r = 2,满足 w + r > n。x 原来是 0,一个写入正在把它改成 1,三个副本还没全部收到。读者甲读了两个副本,拿到 1;甲读完以后,读者乙才开始,读的是另外两个副本。乙可能读到 0 吗?
不可能:w + r > n,读和写的副本一定有重叠,乙一定读到 1
不可能:甲已经读到 1,说明写入已经生效了
可能,但只在有副本宕机或网络分区的时候
可能:什么故障都没有,只因为写入还在路上,乙读的两个副本恰好都还没收到
可能,但只在用时钟打时间戳、时钟又有偏差的时候
三个进程用 Lamport 时间戳给事件编号。事件 p 的时间戳是 (3, A),事件 q 的是 (5, C)。你能得出什么结论?
p 一定发生在 q 之前
p 和 q 一定是并发的,因为它们在不同的进程上
q 不可能发生在 p 之前;但 p 是先于 q 还是和 q 并发,看不出来
什么都得不出来,连 q 会不会先于 p 都不知道
计数差 2,说明从 p 到 q 中间隔了两次消息传递
数据有好几份,机器会坏,网络会慢。怎样让这样一组机器对外表现得像只有一份数据、一个说了算的人?要付出什么?什么时候不值得付?
线性一致性和可串行化都像是「排成一个顺序」,它们各自管的是什么?§1.1
无主复制里 w + r > n 的法定人数读写,为什么还不算线性一致?§1.3
Lamport 时间戳和因果一致,为什么用它给两个库的写入编号还是会出错?§2.2
CAS、共享日志、原子提交为什么都能叫「共识」?哪一个只差一点?§3.1
这一章的骨架
这一章分三段:§1 定义并评估线性一致性,§2 从 ID 生成器绕到逻辑时钟,§3 讲共识。容易乱的是 §2:它看上去跑题了,其实是在比较「保证因果」和「保证线性一致」差在哪,又说明两者都不够用来做容错的锁,把你推进 §3。§3.1 一口气列了五种问题,读的时候每一种都问一句:这里要决定的是「谁赢」还是「什么顺序」。
让几份副本像一份,还要能容错
线性一致性 §1
ID 与逻辑时钟 §2
共识 §3
定义:新近性保证 §1.1
哪里非它不可 §1.2
哪种复制做得到 §1.3
代价:分区与延迟 §1.4
分布式发号丢了顺序 §2
逻辑时钟只保因果 §2.1
线性一致的发号器 §2.2
仍做不了容错的锁 §2.2
FLP 为什么不碍事 §3
五种问题彼此等价 §3.1
任期号加多数票 §3.2
协调服务 §3.3
所以要共识
贯穿全章:在一台机器上都很简单,难在机器会坏、网络会慢
本站画的全章结构。三列从左往右读,中间一列是连接:它说明为什么只有时钟还不够,必须走到共识。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
两个「排成顺序」:可串行化管多对象的事务,排出的顺序可以和真实时间不符;线性一致管单个对象,要求新近。两样都要叫严格可串行化。
四种复制方式:单主要读写都走主、并且确知谁是主;共识大多可以,读也要确认主的身份;多主不行;无主基本不行,法定人数也不够。
真正的代价:多数是为了性能(延迟),不是为了容错;而且这份延迟一直在付,不只在网络出故障时。
逻辑时钟的边界:给出和因果一致的全序;管不了自己没见过的时间戳,所以不线性一致,也分不出并发。
发号器做锁:要确认自己的号最小,得听到所有节点的回音,有一个联系不上就只能干等。
只差一点:拿到 0 的知道自己赢了,其余的只知道自己输了、不知道谁赢;赢家一挂,大家悬着。
先有主还是先有共识:只保证每个任期里主唯一;追加日志前再拉一次多数票,两次多数必然重叠,过期的主会被发现。
分节地图
全章约 1.7 万词,建议分五次读。第一、二次是线性一致性,例子多、读得快;第三次的逻辑时钟篇幅不长但概念密;第四次的 §3.1 是全章最抽象的一节,五种问题一个接一个,最好一口气读完;第五次回到工程,节奏轻一些。
第一次坐下§0–§1.2 · 约 3600 词 · 什么是线性一致,什么时候非它不可
Lots of things can go wrong…约 500 词 开篇 最终一致和强一致两种思路;这一章只走强一致这条路,分三块讲。 Linearizability约 400 词 线性一致性 目标是让多副本的库用起来像单机。一个看比分的例子引出「新近」。 What Makes a System Linearizable?约 1600 词 什么样的系统算线性一致 用请求的时间条画读写,规则一条条加上去;方框区分它和可串行化。 Relying on Linearizability约 1100 词 依赖线性一致的场合 锁与选主、唯一约束、跨通道的时序依赖:三种非它不可的情形。 第二次坐下§1.3–§1.4 · 约 2300 词 · 哪些系统做得到,代价是什么
Implementing Linearizable Systems约 800 词 实现线性一致的系统 第 6 章的几种复制方式逐个过一遍。留意法定人数的那个反例。 The Cost of Linearizability约 1400 词 线性一致的代价 网络断开时只能二选一;CAP 为什么不好用;平时就在付的代价是什么。 第三次坐下§2–§2.2 · 约 3200 词 · 从发号器绕到逻辑时钟
ID Generators and Logical Clocks约 1000 词 ID 生成器与逻辑时钟 单机自增 ID 好在哪;几种分布式发号办法各自丢了什么。 Logical Clocks约 1100 词 逻辑时钟 Lamport 时钟、混合逻辑时钟、向量时钟,各自能比出什么、比不出什么。 Linearizable ID Generators约 1100 词 线性一致的 ID 生成器 只保因果会出什么事;怎样做到线性一致;为什么还不够实现锁。 第四次坐下§3–§3.1 · 约 3300 词 · 共识和它的几副面孔
Consensus约 600 词 共识 前面那些难题其实是同一个问题;方框解释 FLP 结论为什么不妨碍实践。 The Many Faces of Consensus约 2700 词 共识的多种面孔 单值共识、CAS、共享日志、fetch-and-add、原子提交,看它们怎样互相转化。 第五次坐下§3.2–§4 · 约 4300 词 · 真实的共识系统和协调服务
Consensus in Practice约 2000 词 实践中的共识 任期号和两轮投票;新主怎样接住旧日志;共识的好处和代价。 Coordination Services约 1300 词 协调服务 ZooKeeper、etcd 这类系统提供什么,适合和不适合拿来做什么。 Summary约 1000 词 小结 全章回顾。先自己回忆一遍再读它。
先用中文过一遍
线性一致性:假装只有一份数据
复制以后,同一个值在几台机器上各有一份,一次更新到达各处的时间不同。线性一致性(linearizability)要求系统对外表现得像只有一份数据:每个操作都在「请求发出」和「收到响应」之间的某一刻一下子生效。客户端看不到那一刻在哪,只知道它落在自己那根时间条里。
落到读上是两条规矩。和写在时间上重叠的读,读到旧值、新值都行,因为谁也说不清服务器先处理了哪个。但只要有一个读者读到了新值,此后才开始的读,不管来自哪个客户端,都不许再读到旧值;值不能在新旧之间来回跳。所以它是一种关于「新近」的保证。它只管单个对象,不把几次读写打包成事务,这是它和可串行化的分界,§1.1 有个方框专门讲。
售票服务
读者甲
读者乙
写:余票 5 → 4
生效的那一刻(谁也看不见)
读 5
读 5
读 4
读 5 或 4 都行
必须读 4
读到 5 就违规:甲已经读到 4 了
真实时间 →
每根条:左端发出请求,右端收到响应
本站画的示意图,例子是编的。和写重叠的读两种结果都合法;一旦有人读到新值,之后开始的读就只能读新值。
逻辑时钟:数事件,不看钟表
几台机器各自发号时,号码的大小和事件的先后对不上:时钟有快有慢,分段发的号各走各的。逻辑时钟(logical clock)不管现在几点,只数事件。Lamport 的做法就两条:自己每产生一个时间戳,计数先加一;每看到别人带来的时间戳,如果比自己的计数大,就把计数抬到那个值。时间戳写成(计数, 节点 ID),先比计数,计数相同再比节点 ID,任意两个都能比出大小。
它保证的方向是:X 先于 Y 发生(Y 所在的进程沿着消息链能追到 X),X 的时间戳就一定更小。反过来不成立。两件互不知情的事也会被排出一个先后,只看时间戳分不出「先发生」和「并发」。想分辨并发,要用向量时钟:每个节点一格计数,比较时逐格比,代价是时间戳随节点数变长。
进程 A
进程 B
进程 C
(1,A)
(2,A) 发
(1,B)
收到 2:计数 1→2
(3,B) 发
(1,C)
(2,C)
(3,C)
收到 3:计数不变
(4,C)
(1,A) < (3,C),可两件事互不知情:并发
(2,A) 经 B 传到 (4,C):一定更小
本站画的示意图。圆点是产生时间戳的事件,小方块是收到消息:收到只调整计数,不产生新的时间戳。两个带圈的事件计数不同,但谁也不知道谁。
Leslie Lamport,2006 年 9 月在意大利乌迪内的一次 IFIP 会议期间。书里说他 1978 年提出了 Lamport 时钟,那篇论文是分布式系统领域被引用最多的论文之一(§2.1)。§3 点名的 Paxos 共识算法也出自他手,他因分布式和并发系统方面的工作获得 2013 年的图灵奖。照片经本站裁切。Andrej Bauer,CC BY-SA 2.5 si,维基共享资源 共识:任期号,加两次多数票
单主复制里,主节点说了算:谁拿到锁、日志下一条写什么、事务提交还是回滚,都由它决定。难的是主节点挂了怎么办:换主需要所有节点对「谁是主」意见一致,这本身又是一个要达成一致的问题。
常用的共识算法这样绕开:不保证任何时刻只有一个主,只保证每个任期(epoch,Raft 叫 term)里最多一个主,任期号只增不减。某个节点一段时间听不到主的声音,就用一个更大的任期号发起选举,拿到多数票就当选。当选以后,主每要往日志里追加一条,还要再拉一次多数票;投票的节点只要见过更大的任期号,就投反对。两次「多数」必然至少有一个节点重叠,所以一个停顿后醒来、还以为自己是主的旧主,一定会在第二轮投票时撞上那个已经见过新任期的节点。
① 旧主 N1 停顿,N3 用任期 4 拉票:N2、N3、N4 同意,3/5 过半
N1
N2
N3
N4
N5
旧主,正在停顿
新主,任期 4
没收到拉票
② N1 醒来,还用任期 3 想追加一条日志,只联系得上 N2、N5
N1
N2
N3
N4
N5
拒绝:见过任期 4
同意
N2 两轮都在场:两个多数必然重叠。N1 只得 2/5 票,追加失败
本站画的示意图,五个节点、任期号都是编的。真实算法里,旧主收到拒绝后会知道有了新任期,自己退下来。
这一章点名的系统
ZooKeeper 协调服务 用 Zab 共识算法。书里特意说明:它的写是线性一致的,读可能读到旧值。
etcd 协调服务 用 Raft,书里说 Kubernetes 依赖它。从第 3 版起默认提供线性一致的读。
Chubby 锁服务 Google 内部的锁服务,ZooKeeper、etcd 这类协调服务都以它为原型。
Apache Curator 客户端库 在 ZooKeeper 之上提供选主、锁这类现成的做法。
Spanner 分布式数据库 Google 的数据库,提供严格可串行化;时钟读数带误差区间,提交前先等过这段误差。
CockroachDB 分布式数据库 用混合逻辑时钟;书里说它可串行化,但不是严格可串行化。
TiDB / TiKV 分布式数据库 用一个单独的「时间戳预言机」发线性一致的时间戳,思路来自 Google 的 Percolator。
FoundationDB 分布式键值库 书里和 Spanner 并列,提供严格可串行化。
Kafka 消息系统 可以打开「不干净的选主」,让没跟上的副本当主,用一致性换恢复速度。
英文 中文 一句话 linearizability 线性一致性 多副本表现得像只有一份数据,每个操作在某一刻原子地生效(§1)。 register 寄存器 理论里对「一个可读写的对象」的叫法,实际可以是一个键、一行、一个文档(§1.1)。 strict serializability 严格可串行化 可串行化加线性一致:事务排得出顺序,并且这个顺序符合真实时间(§1.1)。 network partition 网络分区 各部分内部通,彼此之间断开(§1.4)。 CAP theorem CAP 定理 网络分区时,在线性一致和可用之间只能选一个(§1.4)。 logical clock 逻辑时钟 数事件的算法,不报时,只能比先后(§2.1)。 Lamport timestamp Lamport 时间戳 (计数, 节点 ID),给出和因果一致的全序(§2.1)。 hybrid logical clock 混合逻辑时钟 按物理时间走,又像 Lamport 时钟那样跟着别人往前拨(§2.1)。 vector clock 向量时钟 每个节点一格计数,能判断两个事件是否并发(§2.1)。 consensus 共识 让多个节点就一个值达成一致,决定了就不再改(§3)。 FLP result FLP 不可能性结论 节点可能崩溃时,没有确定性算法能保证共识总会结束(§3)。 shared log / total order broadcast 共享日志 / 全序广播 多个节点都能请求追加、所有节点按同一顺序读到的日志(§3.1)。 consensus number 共识数 一种原子操作最多能给几个节点解决共识(§3.1)。 epoch number 任期号 每次选主递增的编号,同一任期里最多一个主(§3.2)。 coordination service 协调服务 ZooKeeper、etcd 一类,用共识存少量慢变的协调数据(§3.3)。
动手:模拟器
先猜:A 先做三件本地事件,再给 B 发一条消息;B 之前什么都没做,收到后马上给 C 发一条。B 这条消息带的计数是几?C 在收到它之前自己做了一件事,得到 (1,C)。(1,C) 比 A 发出的 (4,A) 小,C 这件事是不是发生在 A 发消息之前?猜好了再动手。
模拟器 逻辑时钟 三个进程 A、B、C 做本地事件、互相发消息,消息要你手动送达。每个事件带一个 Lamport 时间戳(计数, 进程)。挑两个事件比一比:Lamport 怎么排,真实的因果关系又是什么。
重置。进程选 A,点三次「本地事件」;发给 B,点「发消息」;把这条消息送达。进程选 B,发给 C,点「发消息」,看它带的计数。进程选 C,点一次「本地事件」,再比较 C1 和 A4。
接着把 B 发给 C 的消息送达,让 C 再做一件本地事件,比较 A1 和 C2。然后取消「收到时把计数抬到对方的值」,重置后重复第一题的步骤,看「和因果相反的对」那个数字。
勾上「显示向量时钟」,点几次「随机走 4 步」,找一对计数不同、却是并发的事件。看它们的向量:为什么逐格比较比不出大小?
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(quorum、linearizable 这类)不在这里,在上面的术语表里。
§0 Lots of things can go wrong…
notorious for
… are notorious for being hard to …
出了名地(难、糟)
notorious 带贬义,是「臭名昭著」,和中性的 famous 不同。
fall apart
… but completely fall apart when faced …
彻底垮掉
不是「分开」:系统在某种故障组合下整个失灵。
scratch the surface
… will only scratch the surface.
只触及皮毛
nitty-gritty
… avoid the algorithmic nitty-gritty, formal …
琐碎的细节、具体的门道
口语词,指一件事最具体、最繁琐的那部分。
pointers
… in this chapter provide initial pointers.
线索、入门指引
不是 C 语言的指针:参考文献给你「往哪里去找」的提示。
§1 Linearizability
incredulously
… Bryce incredulously hits reload on …
不敢相信地
§1.1 What Makes a System Linearizable?
flip back and forth
… a value flip back and forth between …
在两个值之间来回跳
strictly after
… read occurs strictly after A’s read, …
严格在……之后(两段时间不重叠)
strictly 在这里排除了「部分重叠」:B 开始时 A 已经结束。
something else again
… is something else again, but we …
又是另一回事
口语,意思是「别和前两个混为一谈」,书里不展开。
§1.2 Relying on Linearizability
frivolous
… is perhaps a frivolous example; a …
无关紧要的、不当真的
recipe
… by providing higher-level recipes on top …
现成的做法、套路
不是菜谱。ZooKeeper 社区就把选主、分布式锁这类用法叫 recipes。
on the critical path
… are on the critical path of transaction …
在关键路径上(每次都要经过、直接决定耗时)
granular
… at a much more granular level …
粒度更细的
claim
… the user who claimed it, provided …
认领、占用
不是「声称」:把一个用户名占为己有。
provided that
… claimed it, provided that the username …
只要、前提是
连词,和「提供」无关。
§1.3 Implementing Linearizable Systems
delusional
… if the delusional leader continues to …
自以为是(主)的
本义「有妄想的」。这个节点真心相信自己还是主,其实早被换掉了。
a different matter
… Cross-shard transactions are a different matter …
另当别论
not quite true
… strong consistency, this is not quite true.
(其实)不对
往轻里说:not quite 字面是「不完全」,作者的意思是这个说法站不住。
at the cost of
… at the cost of reduced performance.
以……为代价
§1.4 The Cost of Linearizability
deserve credit for
… CAP deserves credit for this culture …
在……上功不可没
先给一句肯定,后面再批评,是作者常用的写法。
a burst of
… a burst of new database technologies …
一阵、一波(集中涌现的)
superseded by
… has now been superseded by more …
被……取代
of mostly historical interest
… is of mostly historical interest today.
如今基本只有历史意义
客气的否定:言下之意是设计系统时不必再拿它当依据。
idiosyncratic
… CAP’s idiosyncratic definition of availability.
独特的、和通常理解不一样的
dwell on
… best not to dwell on it.
纠缠于、老惦记着
dwell 本义居住,dwell on 是在一个话题上停留太久。
§2 ID Generators and Logical Clocks
ahead of
… might have been ahead of the other.
(计数)跑在前面
run low
… sequence numbers begins to run low.
快用完了
不是「跑得低」:supply runs low 是存货见底。
vanishingly rare
… that collisions are vanishingly rare …
罕见到几乎为零
at best
… can provide at best an approximate ordering.
充其量、最好也只能
§2.1 Logical Clocks
lexicographic
… using the usual lexicographic string comparison.
按字典序的
wildly different
… could have wildly different counter values.
相差极大
wildly 在这里只是加强语气,没有「野蛮」的意思。
arbitrarily
… these algorithms order them arbitrarily.
随便地(排一个顺序)
不是「武断地」:没有依据,排成哪样都行。
§2.2 Linearizable ID Generators
on the upside
… On the upside, the ID generator’s …
好的一面是
grind to a halt
… this system would grind to a halt …
卡死、停摆
像齿轮磨着磨着停下来。§3.3 又出现一次。
§3 Consensus
get right
… infamously difficult to get right, and …
做对
get it right / get it wrong 是「做对 / 做错」,不是「拿到」。
tackle
… finally ready to tackle the consensus …
着手解决
here we are
… Yet, here we are, discussing algorithms …
可我们偏偏在这儿(讨论它)
作者的自嘲口吻:既然证明了做不到,这一章怎么还在讲?
§3.1 The Many Faces of Consensus
lump together
… why we can lump all these things …
归到一起、一并看待
dictator
… one node to be the “dictator,” and …
独裁者(一个人说了算的节点)
比喻:指定一个节点包办所有决定,最简单,但它一挂就没人能决定了。
sit around
… cannot simply sit around and do …
干坐着(什么也不做)
buried under 30 feet of mud
… is buried under 30 feet of mud …
埋在 30 英尺深的泥里
作者的玩笑,强调「那个节点永远回不来了」。30 英尺约 9 米。
left hanging
… the other nodes are left hanging, unable …
被晾在那儿、悬而未决
may yet
… that read 0 may yet come back …
仍有可能(日后)
yet 在这里不是「但是」,是「到头来还可能」。
§3.2 Consensus in Practice
right out of the box
… provide shared logs right out of the box.
开箱即有、自带
conundrum
… break out of this conundrum?
难题、两难的死结
after all
… leader wasn’t dead after all), then …
原来(其实)
不是「毕竟」:和预想相反,旧主其实没死。
the devil is in the details
… However, the devil is in the details, …
难就难在细节
honor
… new leader honors any log entries …
承认并保留(旧主已经写下的条目)
honor 作动词是「兑现、遵守」,honor a contract 是履行合同。
on thin ice
… but you are on thin ice, since …
如履薄冰、处境危险
lurk
… other places where bugs can lurk …
潜伏、藏着
bounce between
… leadership continually bounces between two nodes, …
在……之间来回换
bounce 本义弹跳,这里是主的位置在两个节点间反复易手。
§3.3 Coordination Services
judicious
… by judicious use of atomic operations, …
审慎得当的
spring up
… that have sprung up to provide …
纷纷出现
spring 在这里是「冒出来」,过去分词 sprung。
overkill
… for service discovery is often overkill.
大材小用、用力过猛
§4 Summary
vested in
… decisions is vested in the leader, …
(权力)归于、交给
法律和公文里的说法:权力被授予某人。
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
书里的答案是第四项(§1.3)。写入是分别发往三个副本的,到达的时间有先有后。甲读的两个副本里有一个已经是 1,按时间戳取新的,读到 1;乙读的另外两个恰好都还没收到,读到 0。整个过程没有任何故障,法定人数的条件也满足,但「甲读完以后才开始的乙读到了更旧的值」,违反了线性一致。书里说要补救,读者在返回前得同步做读修复,写者在写之前也得先从法定人数个副本读到最新的时间戳;即使这样,CAS 也做不出来。想一想:如果每个读者都在返回之前把读到的最新值写回到两个副本上,乙还会读到 0 吗?
书里的答案是第三项(§2.1)。Lamport 时间戳和因果一致:如果 q 先于 p,q 的时间戳一定更小;现在 q 更大,所以 q 不可能先于 p。但反过来不成立,时间戳小不代表先发生,两件互不知情的事照样被排出先后。要分清「先于」和「并发」,得用向量时钟。上面的模拟器里,「计数不同却并发」的那几对就是例子。想一想:如果两个时间戳是 (4, A) 和 (4, C),能得出什么?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
这算哪一种保证被破坏了?§1.1
场景:一个分布式账务库宣称提供「可串行化」。运营在 10:00:05 收到了一笔调账事务提交成功的响应;10:00:07 另一个只读事务查这个账户的余额,看到的是调账之前的数。
违反了可串行化:后执行的事务没看到先提交的事务 没违反可串行化,但不满足线性一致;想排除这种情况要的是严格可串行化 这是写偏斜:两个事务各自读了旧数据 这是脏读:读到了还没提交的数据
可串行化只要求事务的效果等同于某一种串行顺序,这个顺序可以和真实时间不一致,把只读事务排在调账之前也合法,所以读到旧值不算违规。要求「先完成的操作一定被后开始的操作看到」的是线性一致的新近性保证,两者都要叫严格可串行化。写偏斜涉及两个事务基于旧前提各写一笔;脏读是读到未提交的数据,这里读到的是已提交的旧值。
两地部署该选哪种复制?§1.3 §1.4
场景:一款协作文档应用部署在东京和法兰克福两个机房,两地之间的线路每月会断几次,每次几分钟。断线时两地的用户都要能继续编辑,事后合并即可。
单主复制,所有读写都发往主所在的机房 跨两地部署一个五节点的共识集群,东京三个、法兰克福两个 多主复制,每个机房都接受写入,断线时各自排队,恢复后交换并合并 无主复制,配 w + r > n 的法定人数,这样既线性一致又不怕断线
需求是断线时两边都能写,这正是不要线性一致的场合:多主复制让每个机房各自处理写入,恢复后再交换。单主和共识集群在断线时,联系不上主或者处在少数派一侧的机房就写不了(法兰克福那两个节点会停下)。无主加法定人数既不能保证线性一致,在断线、凑不够 w 个副本时也会拒绝写入。
最直接的修法是哪一个?§2.1 §2.2
场景:商品信息和价格存在两个分片上,各自用混合逻辑时钟给写入打时间戳。运营甲先把一件商品「下架」(分片 1),运营乙在聊天群里看到后,把它的价格改成内部测试价 0.01 元(分片 2)。结果有顾客用快照读看到这件商品仍在架上、价格 0.01 元,下了单。
把混合逻辑时钟换成向量时钟 把 NTP 同步的频率调高,减少时钟偏差 让顾客的快照读用一个更新的时间戳 两个分片的写入都从一个线性一致的发号器(单独的时间戳服务)领时间戳
分片 2 从没见过分片 1 的时间戳,它的时钟可能稍慢,于是后发生的改价拿到了更小的时间戳,快照恰好落在两次写之间。因果信息走的是聊天群,系统看不到,逻辑时钟管不着。线性一致的发号器保证「先完成的请求号更小」,不管两边有没有通信,书里 TiDB 的时间戳预言机就是这么做的。向量时钟能告诉你两次写并发,却不能把它们排对;调高 NTP 只能缩小、不能消除误差;快照时间戳选得再新,下一次也可能落在两次写之间。
这个主备切换脚本哪里会先出事?§3.2
场景:团队自己写了一个主备切换脚本:备库 3 秒收不到主库的心跳,就把自己提升为主。复制是异步的,没有用任何共识算法或协调服务。
主库只是一次 4 秒的停顿,醒来后继续接受写入:两个主同时写,已确认的写也可能丢 3 秒太长,故障恢复太慢,用户会看到报错 心跳太频繁,占满了两库之间的带宽 备库的时钟比主库快,心跳的时间判断会出错
只靠超时判断主死了,又没有任期号或防护令牌,停顿后醒来的旧主不知道自己已被替换,两个主同时接受写入,就是脑裂;异步复制下,旧主上已确认但还没复制过去的写也会丢。书里的说法是:做自动切换却没用经过验证的共识算法,多半不安全。超时长短是调参问题;心跳的带宽可以忽略;心跳超时只要在备库本机用单调时钟计时,就不依赖两台机器的时钟同步(第 9 章 §3.1)。
分片分配怎么做最合适?§3.3
场景:一个对象存储系统有 300 台存储节点、2000 个分片,节点会加入、退出、宕机,需要决定每个分片由哪台节点负责。同事提议在全部 300 台节点上直接跑 Raft,让它们一起投票决定分配。
好主意:参与投票的节点越多,能容忍的故障越多,也越快 可以,但把「多数」改成三分之一,选举会快很多 把分配信息放进一个三到五节点的协调服务,存储节点用临时节点登记自己、订阅变更 不需要共识:每个节点按自己的时钟判断谁超时了,各自接管
共识的每次操作都要和多数节点通信,节点越多越慢;书里说在几千个节点上跑共识效率极低,更好的做法是把共识「外包」给少数几台跑协调服务的机器。分片分配变化慢、数据量小,正适合协调服务,临时节点和变更通知正好用来发现节点的加入和消失。把多数降成三分之一,两个不重叠的少数派会各自做出决定;各自按超时接管则会出现两个节点同时认领一个分片。
和本站其他书对照
锁、比较并交换和 ticket 锁 OSTEP 第 28 章 §3.1 说 CAS 和共识等价,而 fetch-and-add 只能给两个节点解决共识。这两个原子操作在单机上就是 CPU 指令,OSTEP 那一页用它们写了自旋锁和按号排队的 ticket 锁,可以先看它们在一台机器上怎么用。
去那一页 → 多处理器的缓存一致性 OSTEP 第 10 章 §1.4 说多核 CPU 的内存也不是线性一致的:每个核有自己的缓存,数据有好几份副本。OSTEP 那一页从调度的角度讲了多个缓存里副本不一致的问题和总线窥探,可以对照着看「一台机器里也有复制」。
去那一页 →
值得停下来的句子
Linearizable systems tend to be higher latency—and this is true all the time, not only during a network fault.— §1.4。本站译:线性一致的系统往往延迟更高,而且一直如此,不只是在网络出故障的时候。
CAP 让人以为线性一致的代价只在网络分区时才付,平时白拿。这句话把账算对了:每次读写都要确认自己看到的是最新的,就要等网络往返,而延迟的上限又说不准。多核 CPU 放弃线性一致、很多分布式数据库不提供它,理由都是性能。读到 §3.2 共识的每一步都要多数派点头时,可以回头再看这句。
Consensus is essentially “single-leader replication done right,” with automatic failover on leader failure— §3.2。本站译:共识本质上就是「做对了的单主复制」,主挂了能自动切换。
§3.1 把共识讲得很抽象,五种问题互相转化;这句话把它拉回读者熟悉的东西。第 6 章的单主复制最难的就是故障切换:脑裂、丢失已确认的写。共识算法没有发明新的复制方式,而是把这一步做到在第 9 章那些故障下也不出错。
检查一下理解
1.(§1.1)和写在时间上重叠的读,读到旧值或新值都可以。线性一致还额外要求了什么? 一旦有任何一个读返回了新值,此后开始的所有读,不管来自哪个客户端,都必须返回新值(直到它再被覆盖)。值不能在新旧之间来回跳,就像存在某一刻它原子地变了。
2.(§1.2)为什么硬性的唯一约束需要线性一致,外键约束却不需要? 两个人同时注册同一个用户名,必须由一个大家都认的最新值来判谁先占到,这和拿锁、做一次 CAS 是一回事。书里说外键、属性约束这类不需要线性一致也能实现。
3.(§1.3)用时钟时间戳做 LWW 的无主数据库,为什么几乎肯定不是线性一致的? 时钟有偏差,时间戳的大小和事件真实的先后可能对不上,后写的值可能因为时间戳更小被丢掉。所以即使用了法定人数,书里也建议默认它不提供线性一致。
4.(§1.4)书里为什么说用 CAP 解释多核 CPU 内存不线性一致是说不通的? 一台机器内部的通信被当作可靠的,一个核和其余部分断开后也不指望它还能正常工作,根本谈不上「分区时选可用」。放弃线性一致是为了性能:缓存比主存快得多。
5.(§2.1)Lamport 时间戳为什么要带上节点 ID? 两个节点可能产生相同的计数。带上节点 ID,计数相同时按节点 ID 比,每个时间戳都唯一,任意两个都能比出大小,构成一个全序。
6.(§2.2)有了线性一致的时间戳,「时间戳最小的赢」为什么仍然做不成容错的锁? 一个节点要确认自己的时间戳最小,必须听到所有可能参与竞争的节点的回音。只要有一个节点挂了或联系不上,就没法确定它的时间戳不更小,系统只能停着等。
7.(§3.1)用 fetch-and-add 做共识,拿到 0 的节点赢。问题出在哪?为什么两个节点时又可以? 其他节点只知道自己输了,不知道谁赢了;赢家如果在通知大家之前挂了,其余节点无法决定,也不能改选别人,因为赢家可能回来。只有两个节点时,可以先交换各自的提议,拿到 1 的那个就知道赢的是对方。
8.(§3.2)共识算法里,选主和追加日志的两次投票,为什么要求法定人数重叠? 重叠保证追加日志的投票里至少有一个节点参加过最近一次成功的选举。如果出现了任期更大的主,旧主拉票时一定会从这个节点那里发现,追加就不会成功。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 共识让一组会坏的机器像一台不会坏的单主机器那样做决定,代价是每一步都要多数节点点头。
读到新值,就回不去了 和写重叠的读新旧皆可;但只要有人读到了新值,之后开始的读都只能是新值。线性一致是新近性保证,只管单个对象。
§1.1 法定人数也会读到旧值 w + r > n,又没有任何故障,和写重叠的两次读仍可能一新一旧。要补救得同步读修复,CAS 仍然做不到。
§1.3 平时就在付的代价 放弃线性一致多半是为了快,不是为了容错。它的响应时间至少和网络延迟的不确定性成正比,不只在断网时慢。
§1.4 计数小不等于先发生 Lamport 时间戳只保证「先发生的更小」。两件互不知情的事也会被随手排个先后,要分出并发得用向量时钟。
§2.1 没交流过,就排不对 两个库各用逻辑时钟,彼此没见过对方的时间戳,后发生的写可能拿到更小的号。线性一致的发号器才能堵住。
§2.2 赢家挂了,输家悬着 fetch-and-add 里拿到 0 的赢,其余的只知道自己输了。赢家没来得及通知就挂,大家既不能决定,也不能改选。
§3.1 每个任期只有一个主 共识不保证任何时刻只有一个主,只保证同一任期里最多一个。追加日志前再拉一次多数票,过期的主就会被发现。
§3.2 共识外包给三五台机器 几千个分片不必都跑共识,把慢变的分配信息交给三到五台机器上的协调服务。服务发现通常连线性一致都不需要。
§3.3