这一章在做什么
进程会崩,网络会断,几个客户端会同时改同一份数据。事务把一组读写打成一个包:要么全部生效,要么全部撤销,出了错应用重试就行。这一章的大头是隔离:为了性能,数据库常用读已提交、快照隔离这类弱隔离,各挡住一部分竞争,丢失更新和写偏斜却可能漏过去;真正的可串行化有串行执行、两阶段锁、SSI 三种做法,代价各不相同。最后讲跨多个节点时怎样用两阶段提交让大家一起提交,以及它在出故障时的麻烦。
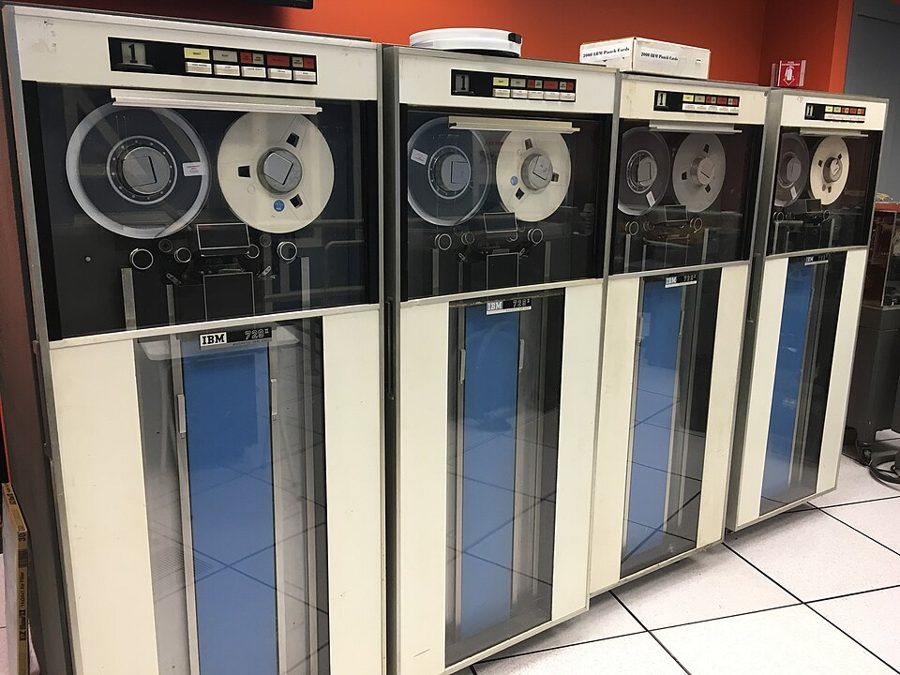
计算机历史博物馆里的一排 IBM 729 磁带机。§1.1 的方框说,「持久」最早指写到归档磁带上,后来指写到磁盘或 SSD,现在常常指复制到别的机器上,而每一种做法都有自己出事的方式。ArnoldReinhold,CC BY-SA 3.0,维基共享资源 读之前:先预测
第 6、7 章把数据复制、分片到多台机器上;这一章回到一个更老的问题:几个客户端同时读写、任何一步都可能崩溃时,数据库能替应用担下多少。第 4 章的预写日志在这里是原子性和持久性的底座,第 6 章「最后写入胜出」会丢掉的更新,这里正面讲怎么防。往后,第 9 章讲网络和时钟为什么靠不住,第 10 章用共识算法替换两阶段提交里那个单点的协调者,第 12、13 章接着讲「恰好一次」和幂等。
一门选修课容量 30 人,已经选了 29 人。两位同学几乎同时点「选课」,每个事务都是:数一数这门课已选几人;少于 30 就插入一条自己的选课记录;提交。数据库用快照隔离,而且开着丢失更新的自动检测(比如 PostgreSQL 的 repeatable read)。最可能的结果是?
后提交的那个因为「并发更新」被数据库中止,人数停在 30
后插入的那个被行锁卡住,等前一个提交后重新数到 30 人,自己放弃
两个都成功,这门课变成 31 人
数据库检测到死锁,中止其中一个
后数人数的那个读到了对方还没提交的插入,数到 30 人,自己放弃
一笔下单跨两个数据库:订单库和库存库,用两阶段提交。两边对「准备」都回答了「是」;协调者把「提交」的决定写进自己的日志,发给了订单库,还没来得及发给库存库就断电了。库存库接下来会怎么做?
等一会儿超时,自己回滚,因为它没收到「提交」
等一会儿超时,自己提交,因为它已经答应过
去问订单库的结果,照着做
一直等协调者恢复;在这期间,这笔事务改过的行一直锁着
立刻回滚,并通知应用重试整笔下单
几个客户端同时读写同一份数据,任何一步都可能失败。数据库能把多少种竞争和故障替应用挡掉?挡得越多,要付出多少等待和中止?
读已提交已经保证了不脏读、不脏写,为什么两个人同时给计数器加一还会少加一次?§2.1 §2.3
写偏斜和丢失更新差在哪?为什么快照隔离自带的丢失更新检测抓不住它?§2.4
两阶段锁「先等再说」,SSI「先做再查」。它们各在什么样的负载下吃亏?§3.2 §3.3
两阶段提交里,协调者一崩溃,参与者为什么只能干等?§4.1
这一章的骨架
这一章按「事务要对付什么」分三块:出错(§1),并发(§2–§3),跨节点(§4)。篇幅最大、最容易乱的是并发:§2 一级一级讲弱隔离,每讲一级就冒出一种它挡不住的竞争,到 §3 才给出能全挡住的三种实现。读的时候在纸上画一张表:横着是隔离级别,竖着是竞争的种类,每读到一处就填一格。
事务:一组读写,当成一件事
出错时:原子性 §1
并发时:隔离 §2–§3
跨节点:原子提交 §4
ACID 四个字母 §1.1
持久性靠什么 §1.1
一次改好几个对象 §1.2
出错就中止、重试 §1.2
读已提交 §2.1
快照隔离与多版本 §2.2
丢失更新 §2.3
写偏斜和幻读 §2.4
全挡住:可串行化 §3
真的一个一个跑 §3.1
两阶段锁 §3.2
可串行化快照隔离 §3.3
各自提交会出什么事 §4
两阶段提交 §4.1
协调者崩溃:存疑 §4.1
跨异构系统:XA §4.2
数据库内部的事务 §4.3
只靠本库做到恰好一次 §4.4
弱隔离可能漏掉的竞争
会把系统卡住的地方
问题的出路
贯穿全章:保证越强,等待和中止越多;保证越弱,应用自己要防的越多
本站画的全章结构。中间一列是全章的重心,橙色两格是弱隔离可能漏掉的竞争,绿色那格之后是三种全挡住的办法。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
A 到底管什么:出错时把这个事务已经做的写全部丢掉,让应用可以放心重试;作者说叫「可中止性」更贴切。
C 归谁:不变式是应用定义的,数据库只能替你检查声明成约束的那部分,其余要靠应用把事务写对。
快照怎么做:每行可以有好几个版本,标着创建它和删除它的事务号;看开始时哪些事务还在进行、谁的事务号更大、谁中止了。
写偏斜的套路:先查条件,按结果做决定,再写入,而写入改变了刚才的前提;查的是「不存在的行」时没有行可锁。
两阶段锁的代价:读写互相阻塞,并发度低,死锁更多;一个慢事务或一个大读事务就能让别人全排队。
SSI 何时中止:读快照时忽略了别人未提交的写、读完之后别人又写了;只读事务不必中止,对方也可能回滚。
不能反悔的点:参与者回答「是」的那一刻,协调者把决定写进日志的那一刻。
分节地图
全章约 2.2 万词(不算代码和图注),是全书最长的一章,建议分六次读。第二、三次是全章的重心,最好连着读;第四、五次讲可串行化的三种实现;第六次的 XA 部分细节多,抓住「存疑时一直持锁」这一条就够。
第一次坐下§0–§1.2 · 约 4300 词 · 事务是什么,ACID 四个字母各管什么
In the harsh reality of…约 500 词 开篇 会出错的种种;事务是为简化编程而发明的,不是每个应用都离不开它。 What Exactly Is a Transaction?约 300 词 事务到底是什么 从 System R 到 NoSQL 丢掉事务,再到 NewSQL 把它找回来。 The Meaning of ACID约 1900 词 ACID 的含义 四个字母逐个拆开。抓住两点:原子性不管并发,一致性属于应用。方框讲持久性的种种不可靠。 Single-Object and Multi-Object Operations约 1600 词 单对象与多对象操作 什么时候非得一次改好几个对象;单对象也要原子性;中止后重试的几个坑。 第二次坐下§2–§2.2 · 约 3700 词 · 读已提交和快照隔离
Weak Isolation Levels约 500 词 弱隔离级别 数据库为什么不默认可串行化;弱隔离造成的 bug 有多真实。 Read Committed约 1000 词 读已提交 两条保证:不脏读、不脏写。各自通常怎么实现,为什么读不加锁。 Snapshot Isolation and Repeatable Read约 2200 词 快照隔离与可重复读 读偏斜是什么;多版本和可见性规则怎么给出一致的快照;名字为什么一团乱。 第三次坐下§2.3–§2.4 · 约 3100 词 · 两个事务同时写
Preventing Lost Updates约 1400 词 防止丢失更新 读-改-写循环的几种对策,各自要应用做什么;复制的数据库里为什么又不一样。 Write Skew and Phantoms约 1700 词 写偏斜与幻读 两人改的不是同一行,照样出错。抓住几个例子共同的四步套路。 第四次坐下§3–§3.2 · 约 3700 词 · 可串行化:真串行和两阶段锁
Serializability约 400 词 可串行化 弱隔离的困境;实现可串行化的三条路。 Actual Serial Execution约 1600 词 真正的串行执行 单线程一次跑一个事务为什么又行得通了;存储过程和分片各有什么代价。 Two-Phase Locking约 1700 词 两阶段锁 读写互斥的锁、它的性能问题,以及谓词锁、索引范围锁怎么挡住幻读。 第五次坐下§3.3–§4.1 · 约 3900 词 · 乐观的 SSI,然后进入分布式提交
Serializable Snapshot Isolation约 1800 词 可串行化快照隔离 先放行、提交时检查前提有没有过时。留意两种检测情形的区别。 Distributed Transactions约 700 词 分布式事务 单机靠一条提交记录做到原子提交,多个节点为什么不能各提交各的。 Two-Phase Commit约 1500 词 两阶段提交 两轮请求、两次承诺,协调者崩溃时参与者的处境,三阶段提交为什么不现实。 第六次坐下§4.2–§5 · 约 3400 词 · XA 的麻烦、数据库内部的事务、恰好一次
Distributed Transactions Across Different Systems约 1800 词 跨不同系统的分布式事务 XA 怎么工作;存疑的事务为什么一直持锁;协调者坏了谁来收拾。 Database-Internal Distributed Transactions约 300 词 数据库内部的分布式事务 同一套软件内部的两阶段提交,为什么没有 XA 那些毛病。 Exactly-Once Message Processing Revisited约 500 词 再谈恰好一次的消息处理 只用数据库自己的事务,怎样让每条消息的效果恰好出现一次。 Summary约 800 词 小结 全章回顾。先自己把几种竞争和隔离级别对一遍,再读它。
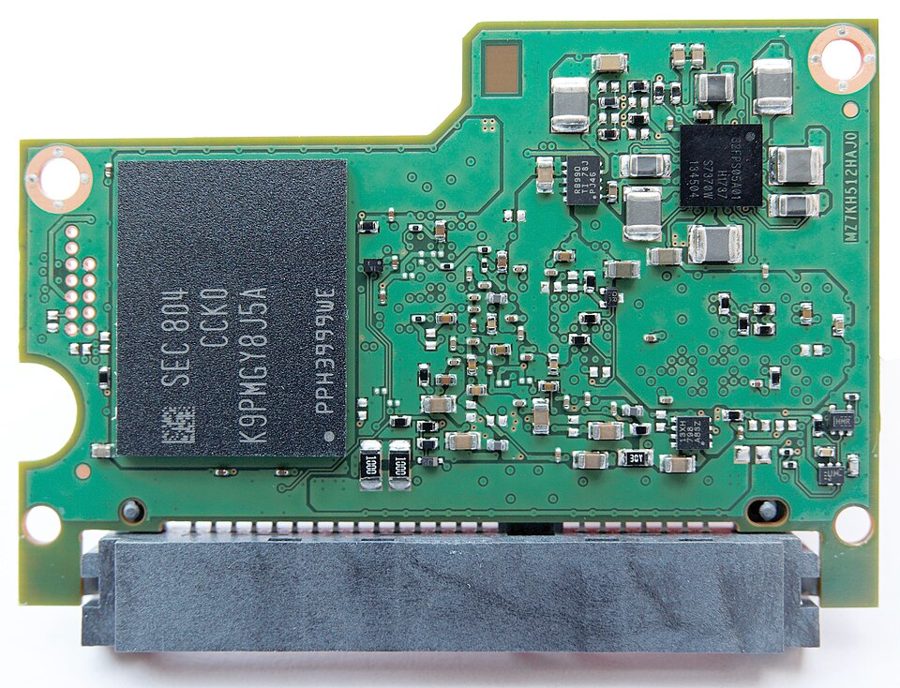
一块 512 GB 固态盘(三星 860 Pro)拆掉外壳后的电路板。§1.1 的方框列了这类设备出事的几种方式:突然断电时连 fsync 都可能不作数;书里引的一项研究发现,头四年里 30% 到 80% 的盘至少出一个坏块;磨损多了的盘断电放着,几周到几个月就可能丢数据。所以作者说,持久性只有一层层降低风险的手段,没有绝对的保证。Michael Bemmerl,CC BY 3.0 de,维基共享资源 先用中文过一遍
读已提交和快照隔离:读到的是哪个版本
隔离要解决的是:几个事务同时跑,彼此别踩到对方。最弱的一档实用级别是读已提交,它保证两件事:只读得到别人已经提交的数据(不脏读),只覆盖别人已经提交的数据(不脏写)。不脏写靠行锁:要改一行先拿锁,拿到提交或中止才放。不脏读通常不用锁,而是让数据库同时记着这一行的旧值(已提交的)和新值(还没提交的),别的事务来读,就给它旧值。
读已提交挡不住一种情况:一个事务先后读两行,两次之间别人改了这两行并提交了,它看到的是一半旧、一半新。只读一下,过几秒刷新就好;可要是备份或对账这种要跑几个小时的读,就会读出一个从来没存在过的状态。快照隔离的办法是把「旧值和新值」推广成「好几个已提交的版本」:每个版本标着是哪个事务创建的、哪个事务删除的(更新就是删一个旧版本、加一个新版本)。事务开始时记下当时还有哪些事务没提交,之后读任何一行,都只挑「开始那一刻已经提交」的那个版本。这就是多版本并发控制(MVCC)。读的人不挡写的人,写的人也不挡读的人。
一行「耳机库存」,存着三个版本
值
谁创建的
谁删除的
10 tx 90 · 已提交 tx 96
8 tx 96 · 已提交 tx 99
5 tx 99 · 进行中 —
tx 97 来读
开始时 96 还没提交:它的删和建都不算
99 比自己晚开始:也不算
看到 10
tx 100 来读
开始时 96 已提交,99 还在进行
看到 8
可见的条件:创建它的事务在我开始时已提交;
而且没被删,或者删它的事务在我开始时还没提交。
本站画的示意图,事务号和库存数是编的。两个读者在同一时刻读同一行,因为开始的时间不同,看到的是不同的版本。旧版本要等没有任何事务还需要它时,才由后台的垃圾回收清掉。
两个事务同时写:丢失更新和写偏斜
前面两级主要管「读的人看到什么」。两个事务都要写时,问题更多。最常见的是丢失更新:两个事务都先读一个值、在程序里改、再整个写回去,后写的那个把先写的冲掉了。读已提交挡不住它:后一次写发生在前一个事务提交之后,算不上脏写。对策有好几种:让数据库做原子的「在原值上加减」,显式给要改的行加锁,让数据库自动检测并中止后写的那个,或者用「值没变才写」的条件写。
写偏斜更隐蔽:两个事务读的是同一批数据,改的却是不同的行。每个事务都先查一个条件(「还有空位吗」),按结果决定写入,而它的写入恰好让对方的条件不再成立。因为两人改的不是同一行,行锁、丢失更新检测统统看不到冲突。更麻烦的是,如果条件查的是「没有符合条件的行」,就连一行可以加锁的东西都没有,这就是幻读引起的写偏斜。
丢失更新:改的是同一行
A:卖 1 件
B:卖 2 件
读库存 = 10
读库存 = 10
写 9,提交
写 8,提交
库存 8:A 卖掉的那一件没扣上
同一行:原子操作、加锁、
自动检测、条件写都能挡
写偏斜:各写各的行
A:选课
B:选课
数已选 = 29
数已选 = 29
29 < 30,插入 A
29 < 30,插入 B
31 人,超出容量 30
两条新记录互不相干:行锁和
丢失更新检测都看不见冲突
本站画的示意图,从上往下是时间顺序。两边的形状很像,差别只在最后写的是不是同一行。右边这种在快照隔离下照样会发生。
要全挡住:可串行化的三种做法
可串行化的意思是:不管事务实际上怎么交错执行,结果都和某个「一个接一个跑」的顺序一样。这样只要每个事务单独跑是对的,一起跑也是对的。书里讲了三种实现。第一种最直接:真的只用一个线程,一次跑一个事务。前提是事务都很短、数据都在内存里,而且事务要写成存储过程整个交给数据库,不能和应用来回聊。第二种是两阶段锁:读要拿共享锁,写要拿排他锁,读写互相等,拿到的锁一直留到事务结束;为了挡住幻读,还要锁住「查询条件」或者索引上的一段范围。第三种是可串行化快照隔离(SSI):照快照隔离那样放手让事务跑,只是暗中记下谁读了什么、谁写了什么,到提交时检查自己当初读到的前提有没有被别人改掉,改掉了就中止。前两种是悲观的,有风险就等;第三种是乐观的,先做,出了问题再撤。
跨节点提交:两阶段提交的两次承诺
单机上,「提交」落在一个确定的时刻:提交记录写进磁盘上的日志的那一刻。事务涉及好几个节点时,不能简单地给每个节点发一句「提交」:有的节点可能提交了,有的因为冲突、超时或崩溃回滚了,而已经提交的数据别人可能已经读走,收不回来。两阶段提交加了一个协调者,把提交拆成两轮。第一轮问每个参与者「你能提交吗」,参与者答「是」之前,要先把数据写盘、查过约束,答了就不能反悔。第二轮,协调者收齐答复,把决定写进自己的日志,然后通知所有人。这个决定一旦写下,就要不停重试直到人人照办。代价也在这里:参与者答了「是」之后,如果协调者崩溃,它既不能自己提交,也不能自己回滚,只能拿着锁等。
协调者
订单库
库存库
① 能提交吗?
写盘,答「是」
写盘,答「是」
不能反悔 ①
不能反悔 ①
把「提交」写进日志
← 不能反悔 ②
② 提交
提交,放锁
断电 ✗
存疑:该提交还是回滚?
锁一直不放
只有协调者恢复、读自己的日志,
库存库才知道结局
本站画的示意图,两个参与者是编的。蓝字标出的「不能反悔」是两阶段提交成立的关键;右下的「存疑」是它最大的麻烦,§4.2 讲这些锁会把系统的其他部分也卡住。
这一章点名的系统
System R IBM 的早期关系数据库 第一个 SQL 数据库。今天主流数据库的事务支持仍和它的风格出奇地像。
VoltDB 内存数据库 单线程串行执行事务,事务写成 Java 或 Groovy 的存储过程;复制时在每个副本上重跑同一个存储过程。
Datomic 数据库 也串行执行事务;书里还举它做例子:用不可变的写时复制 B 树提供快照。
FoundationDB 分布式数据库 用 SSI 一类的算法做可串行化,把冲突检测分散到多台机器上。
CockroachDB NewSQL 数据库 分片加共识协议,跨分片的事务;可串行化用的也是 SSI 一类的算法。
Aurora DSQL 云数据库 书里说它和 Oracle、TiDB 一样,把快照隔离当作最高的隔离级别。
BadgerDB 嵌入式存储引擎 书里列的用 SSI 一类算法的嵌入式引擎。
Narayana、MSDTC 事务协调者 两阶段提交里的协调者(事务管理器)的实现,书里点名的几个之二。
英文 中文 一句话 transaction 事务 把一组读写当成一个整体:全部提交(commit),或者全部中止(abort)(§0)。 ACID ACID 原子性、一致性、隔离性、持久性。作者说它如今多半是营销用语(§1.1)。 dirty read / dirty write 脏读 / 脏写 读到、或者覆盖了别人还没提交的数据(§2.1)。 read committed 读已提交 不脏读、不脏写。很多数据库的默认隔离级别(§2.1)。 snapshot isolation 快照隔离 每个事务从开始那一刻的一致快照里读(§2.2)。 MVCC 多版本并发控制 一行同时保留几个版本,按事务号决定谁看到哪个(§2.2)。 read skew 读偏斜 一个事务在不同时刻读到数据库的不同部分,凑出一个不存在的状态(§2.2)。 lost update 丢失更新 两个读-改-写循环同时跑,后写的冲掉了先写的(§2.3)。 write skew 写偏斜 按读到的前提做决定并写入,写的时候前提已被别人改掉(§2.4)。 phantom 幻读(幻影) 一个事务的写,改变了另一个事务某个查询条件的结果(§2.4)。 serializability 可串行化 并发执行的结果和某种一个接一个执行的结果相同(§3)。 two-phase locking (2PL) 两阶段锁 读写都加锁、锁拿到事务结束才放的可串行化实现(§3.2)。 serializable snapshot isolation (SSI) 可串行化快照隔离 在快照隔离上加冲突检测,提交时中止前提过时的事务(§3.3)。 two-phase commit (2PC) 两阶段提交 让多个节点要么都提交、要么都中止的协议(§4.1)。 idempotent 幂等 做一次和做好几次效果一样,因而可以放心重试(§4.4)。
动手:模拟器
先猜:库存 10 件,A 买 1 件、B 买 2 件,都按「读库存 → 写回减过的数 → 提交」来,顺序是 A 读、B 读、A 写、B 写、A 提交、B 提交。读已提交下最后剩几件?换成「快照隔离(检测丢失更新)」,谁会被中止、在哪一步?换成两阶段锁呢?猜好了再点「坏交错:自动走」验证。
模拟器 两个事务交错执行 选一个场景和隔离级别,用「A 走一步」「B 走一步」自己安排两个事务的交错,看谁要等锁、谁被中止、最后的数据对不对。数据和场景都是本站编的。
场景 丢失更新:两单扣同一行库存 写偏斜:抢最后一个名额 读偏斜:调仓时对账
隔离级别 读已提交 快照隔离(不检测丢失更新) 快照隔离(检测丢失更新) 可串行化:两阶段锁 可串行化:SSI
A 走一步
B 走一步
坏交错:自动走
重试被中止的事务
重置
选一个场景和隔离级别,然后点「A 走一步」「B 走一步」自己安排交错,或者直接点「坏交错:自动走」。
场景「丢失更新」,五种隔离级别各点一次「坏交错:自动走」。哪几种最后剩 8 件?其余几种里,B 是在哪一步、因为什么被中止的?点「重试被中止的事务」再把 B 走完,库存对了吗?
场景「写偏斜」,在「快照隔离(检测丢失更新)」下自动走:检测为什么没起作用?换两阶段锁:谁先停下来等、谁被中止,为什么算死锁?换 SSI:两个事务都顺利走到提交,谁在提交那一刻被拒?
场景「读偏斜」,手动走:A 开始、A 读东仓,然后一直点「B 走一步」,直到 B 走完或者走不动,再把 A 走完,最后把 B 走完。读已提交下 A 算出的合计是多少?快照隔离和两阶段锁都给出 100,但 B 的经历完全不同,差在哪?
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(compaction、quorum 这类)不在这里,在上面的术语表里。
§0 In the harsh reality of…
the mechanism of choice
… transactions have been the mechanism of choice …
首选的机制
X of choice 是「首选的 X」,不是「可供选择的 X」。
take them for granted
… we shouldn’t take them for granted. …
把它们当成理所当然
a law of nature
… Transactions are not a law of nature; …
自然规律(天生就该有的东西)
作者的意思:事务是人为了某个目的设计出来的,可以有,也可以不要。
grief
… transactions can prevent a lot of grief; …
麻烦、苦头
不是「悲伤」。cause grief、save yourself a lot of grief 都是这个意思。
come into play
… subtle but important details come into play.
牵涉进来、开始起作用
§1 What Exactly Is a Transaction?
uncannily similar
… is uncannily similar to that …
像得出奇
uncanny 本义「诡异、不可思议」。
casualty
… the main casualty of this movement: …
牺牲品
本义是伤亡人员。NoSQL 运动里,第一个被扔掉的就是事务。
§1.1 The Meaning of ACID
coin a term
… The term was coined in 1983 …
创造一个说法
coin 当动词:铸造,引申为「造新词」。
the devil is in the details
… but the devil is in the details.
难处都藏在细节里
sensible
… the only sensible definition of BASE …
说得通的、合理的
不是 sensitive(敏感)。这句在挖苦:BASE 唯一说得通的定义就是「不是 ACID」。
stick with
… but we will stick with atomicity …
沿用、不换
overloaded
… The word consistency is terribly overloaded: …
(一个词)身兼太多意思
和编程里的「重载」同源,不是「过载」。下面一口气列了五种 consistency。
credits and debits
… credits and debits across all accounts …
贷方和借方(记账的两边)
step on each other’s toes
… they cannot step on each other’s toes.
互相妨碍、干扰对方
knock out
… can knock out all replicas at once …
一下子打垮
track down
… bugs that are hard to track down …
追查到(根源)
with a grain of salt
… with a healthy grain of salt.
别全信,打个折扣听
take something with a grain of salt。healthy 在这里是「适量的、明智的」。
§1.2 Single-Object and Multi-Object Operations
all-or-nothing
… by giving an all-or-nothing guarantee.
要么全有、要么全无的
spliced together
… old and new values spliced together?
拼接在一起
splice 本是接绳子、剪接胶片:一半旧值、一半新值接成一个。
best effort
… on more of a “best effort” basis, …
尽力而为(不作保证)
技术语境里是「尽量做,做不到不负责」,往往暗含「靠不住」。
happy path
… think only about the happy path …
一切顺利时走的那条路径
intricacies
… the intricacies of error handling.
错综复杂的细节
bubble up
… an exception bubbling up the stack, …
(异常)沿调用栈一层层往上抛
this is a shame
… This is a shame, because …
这很可惜
shame 在这里不是「羞耻」。
§2 Weak Isolation Levels
get unlucky with the timing
… when you get unlucky with the timing.
赶上时机不巧
miss the point
… but that misses the point.
没说到点子上
作者的反驳:很多「ACID 数据库」默认用的也是弱隔离,照样挡不住这些 bug。
§2.1 Read Committed
mishap
… Read-committed isolation prevents such mishaps.
差错、小事故
knock-on effect
… can have a knock-on effect in …
连锁反应
operability
… is bad for operability: …
可运维性
§2.2 Snapshot Isolation and Repeatable Read
could be forgiven for thinking
… you could be forgiven for thinking …
这么想情有可原(但其实不对)
先让一步,后面马上要反驳。
vanish into thin air
… vanished into thin air.
凭空消失
a boon for
… Snapshot isolation is a boon for …
对……是福音
ostensibly
… despite those guarantees being ostensibly standardized.
表面上、名义上
nobody really knows
… nobody really knows what repeatable read …
谁也说不清
作者故意说重话:标准写得含糊,各家实现又各不相同。
§2.3 Preventing Lost Updates
clobber
… the later write clobbers the earlier write.
(把别人写的值)冲掉
本义猛击。程序员行话,指不打招呼地覆盖掉别人的数据。
the offending transaction
… and abort the offending transaction.
惹出问题的那个事务
offending 是「肇事的」,不是「冒犯人的」。
take on another dimension
… preventing lost updates takes on another dimension.
又多出一层(复杂性)
after the fact
… merge these versions after the fact.
事后
§2.4 Write Skew and Phantoms
on call
… manage their on-call shifts at a hospital.
值班待命
go off call 是退出待命。
esoteric
… may seem like an esoteric issue …
冷僻的、少有人碰到的
leak into
… mechanism leak into the application data model.
(本该藏在底层的东西)渗到……里
抽象「泄漏」:并发控制的细节跑进了业务的数据模型。
a last resort
… should be considered a last resort …
最后的手段(别无他法才用)
§3 Serializability
find their way into
… found their way into practical use.
进入(实际使用)
all along
… All along, the answer from researchers …
一直以来
§3.1 Actual Serial Execution
sidestep
… we completely sidestep the problem of …
绕开(问题)
neat
… thought that it would be neat if …
巧妙、漂亮
口语里的 neat 常是「很棒」,不是「整洁」。
critical path
… taken out of the critical path, …
关键路径(决定总耗时的那一串步骤)
archaic
… quite ugly and archaic from today’s point …
古旧、过时的
in lockstep
… performed in lockstep across all shards …
步调一致地
本义是队列行进时前后脚紧跟。
orders of magnitude
… orders of magnitude below its single-shard throughput …
好几个数量级
stall
… only one slow transaction to stall …
卡住、让……停下来
§3.2 Two-Phase Locking
behind someone’s back
… change the object unexpectedly behind A’s back.
背着某人、趁其不备
grind to a halt
… system to grind to a halt.
慢慢卡死、停摆
gloss over
… we glossed over a subtle but important …
一笔带过、略过
compromise
… they are a good compromise.
折中方案
名词,不带「让步、委屈」的贬义。
fallback
… but it’s a safe fallback position.
退路、兜底的做法
§3.3 Serializable Snapshot Isolation
paint a bleak picture
… painted a bleak picture of concurrency control …
把情况说得很不乐观
at odds with
… fundamentally at odds with each other?
彼此矛盾、不可兼得
spare capacity
… if there is enough spare capacity, …
富余的处理能力
tripwire
… the lock acts as a tripwire; …
绊线
碰到就报警,但不拦人:SSI 的「锁」只记下冲突,不让别人等。
a matter of debate
… is a matter of debate: …
还有争议
§4 Distributed Transactions
retroactively
… retroactively declared not to have existed.
事后追溯地
§4.1 Two-Phase Commit
surely
… Surely the prepare and commit requests …
难道不也……吗
Surely 开头,常是作者替读者提出质疑,下面再回答。
surrender the right to
… the participant surrenders the right to abort …
交出……的权利
point of no return
… two crucial “points of no return”: …
一过就不能回头的点
unilaterally
… it can no longer abort unilaterally …
单方面地
§4.2 Distributed Transactions Across Different Systems
a mixed reputation
… transactions and 2PC have a mixed reputation.
毁誉参半
kill performance
… operational problems, killing performance, …
把性能拖垮
engender
… the operational problems they engender.
引起、招致
dismiss outright
… rather than dismissing distributed transactions outright, …
一口否定
conflate
… distributed transactions are often conflated: …
混为一谈
get on with
… just get on with its work …
接着干(自己的事)
a sticky situation
… It’s a sticky situation.
棘手的局面
escape hatch
… an emergency escape hatch called heuristic decisions: …
应急出口(绕过正常规则的后门)
euphemism
… is a euphemism for probably breaking atomicity, …
委婉说法
要反着读:所谓「启发式决定」,说白了就是「很可能破坏了原子性」。
lowest common denominator
… it is necessarily a lowest common denominator.
最小公分母(只能做各方都支持的那点最基本的事)
§4.3 Database-Internal Distributed Transactions
a defining feature
… are a defining feature of “NewSQL” databases …
标志性的特点
§4.4 Exactly-Once Message Processing Revisited
lying around
… an old message ID lying around, …
闲放着(没人管)
§5 Summary
manage without
… can probably manage without transactions.
没有……也过得去
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
答案是第三项(§2.4):两个都成功,31 人。这正是写偏斜:两个事务读的是同一组行,各自插入的却是不同的新行。丢失更新检测只管「同一行被两个事务改了」,这里没有同一行;行锁也锁不到还不存在的行;快照隔离下谁也看不到对方没提交的插入,所以不会读到 30。书里说,PostgreSQL 的 repeatable read、MySQL 的 repeatable read、Oracle 的 serializable、SQL Server 的快照隔离都不会自动检测写偏斜,要挡住它需要真正的可串行化(§3)。想一想:如果把「已选人数」存成课程表上的一个计数字段,两个事务都去改它,答案会变吗?
答案是第四项(§4.1)。库存库答了「是」,就交出了单方面中止的权利;它又不知道协调者的决定,自己提交也不安全,因为可能有别的参与者投了反对。问订单库听起来可行,但那不是两阶段提交协议的一部分。它只能等协调者恢复、从日志里读出决定再通知它,这段时间里这笔事务改过的行一直锁着(§4.2 讲了这为什么会把系统的其他部分也卡住)。想一想:如果协调者自己用共识算法复制成几台、一台坏了另一台接手(§4.3,第 10 章),库存库还要等多久?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
积分少加了一次,最省事的修法是?§2.3
场景:会员积分服务用 PostgreSQL 的默认隔离级别(读已提交)。代码通过 ORM 先把用户记录查出来,在程序里给积分加上这次的奖励,再整条保存回去。大促期间偶尔有用户反映同一时刻的两笔奖励只到账一笔,日志里没有任何报错。
改成读未提交,每次都读到最新的值,就不会丢了 改用数据库的原子更新:一条语句让积分在原值上加,不在程序里算 在应用前面加一层缓存,减少对数据库的读 捕获数据库的异常,出错时自动重试事务
这是丢失更新:两个读-改-写循环交错,后写的冲掉了先写的。读已提交不防它,因为后一次写发生在前一个事务提交之后。原子更新让数据库自己在原值上加,是书里说的首选;显式加锁(SELECT FOR UPDATE)也行。读未提交只能降低概率,挡不住;缓存与此无关;这里根本没有报错,重试无从谈起。
同一个用户领到两张首单券,加哪一样最划算?§2.4
场景:新用户可以领一张首单券,每人限一张。领券接口在一个事务里先查「这个用户领过没有」,没领过就插入一条领券记录。数据库用快照隔离。日志显示偶尔有人领到两张,都是用户连点了两下。
把那条查询改成 SELECT … FOR UPDATE,锁住查到的行 打开数据库的丢失更新自动检测 在领券表上建「用户 ID + 券类型」的唯一约束 前端按钮点一次就置灰,防止连点
这是幻读造成的写偏斜:两个事务都查到「没有」,各插入一条。查的是不存在的行,SELECT FOR UPDATE 没东西可锁;两条插入是不同的行,丢失更新检测也看不见。唯一约束让第二条插入直接失败,简单可靠。前端置灰挡不住重放的请求,书里提醒过攻击者会故意并发地打你的接口。
对账一跑,下单就超时。保留可串行化,该怎么改?§3.2 §3.3
场景:订单库用两阶段锁实现可串行化。每晚的对账任务要在一个事务里扫一遍整张订单表,跑 40 分钟;这 40 分钟里,下单接口大面积超时。
换成可串行化快照隔离(SSI),对账在一致的快照上读,不拿锁 把数据库连接池调大一倍 把对账拆成十个并行的扫描,每个扫一段 改成单线程真串行执行,所有事务排队
两阶段锁下,读整张表要拿整张表的共享锁,在它提交之前所有写都得等。SSI 里读不挡写、写不挡读,只读事务在快照上跑,不用拿锁,书里说长时间的只读事务在 SSI 下没问题。连接池大了也只是更多人排队;拆成并行扫描照样要拿共享锁;真串行执行下这 40 分钟的事务会让所有事务都停下。
消息重投导致商家余额加了两次。最稳妥的修法是?§4.2 §4.4
场景:支付成功的消息从消息队列进来,消费者在数据库里给商家余额加钱,提交后向队列确认。偶尔消费者在提交之后、确认之前崩溃,队列把消息重投一次,钱就加了两次。有人提议上 XA,把消息确认和数据库写放进同一个两阶段提交。
上 XA:队列和数据库一起两阶段提交 先向队列确认,再去改数据库 把消费者的处理超时调长一些 在同一个数据库事务里记下消息 ID(带唯一约束),重投时发现已处理就直接确认
书里 §4.4 的做法:只用数据库自己的事务,把消息 ID 和业务写一起提交,处理就变成幂等的,重投也只生效一次。XA 理论上可行,但要求两边都支持,协调者一出问题,存疑的事务就一直持锁,书里花了整整一节讲这些麻烦。先确认再处理,崩溃时会丢消息;调超时与崩溃无关。
用单线程串行执行,最先出问题的会是哪里?§3.1
场景:一个抢购系统想用「单线程一次跑一个事务」换取可串行化:热数据全在内存,下单事务写成存储过程,平均 50 微秒跑完。运营后台还有一个「导出全部订单」的功能,也作为一个事务在这个线程上跑,要 3 秒。
存储过程不好调试、不好做版本管理 内存放不下全部热数据 导出的那 3 秒里,所有下单事务都在排队 并发事务之间频繁死锁
串行执行要求每个事务都又小又快,一个慢事务就能让整条流水线停下。书里的办法是让只读的长查询在快照上跑,放到串行执行的循环之外。存储过程难管理是真问题,但不是最先爆的;题目说了热数据在内存里;只有一个线程,谈不上死锁。
和本站其他书对照
读写锁 OSTEP 第 31 章 两阶段锁里的「共享模式、排他模式」,就是线程编程里的读写锁:多个读者可以一起进来,写者要独占。OSTEP 那一章用信号量亲手实现了一个,也讲了读者太多时写者会饿死。
去那一页 → 原子性违反和死锁 OSTEP 第 32 章 「先检查、再使用,中间被别人插队」的原子性违反,和这一章的写偏斜是同一个形状,只是主角从线程换成了事务。死锁的「检测与恢复」,就是数据库发现死锁后中止其中一个事务的做法。
去那一页 → 提交记录 OSTEP 第 42 章 §4 说单机事务提交的那一刻,是提交记录写进磁盘的那一刻。OSTEP 的文件系统日志里,事务结束块落盘就算提交,崩溃后没有结束块的事务直接丢弃,是同一个想法。
去那一页 →
值得停下来的句子
Transactions are not a law of nature; they were created with a purpose—namely, to simplify the programming model for applications accessing a database.— §0。本站译:事务不是自然规律;它是带着目的被造出来的,那就是让访问数据库的应用编程起来更简单。
这句话定下了全章的读法。既然事务是为了简化编程而存在,评价一个隔离级别、一个提交协议,就要问它替应用挡掉了哪些情况、还剩哪些要应用自己操心。后面讲弱隔离时作者一再抱怨,正是因为它们把一部分复杂度又推回给了应用,而且推得不明不白。
the database guarantees that if the transactions behave correctly when run individually, they continue to do so when run concurrently— §3。本站译:数据库保证,如果事务单独运行时行为正确,那么并发运行时也依然正确。
这是可串行化最有用的一种说法。它把「并发对不对」这个难问题,换成了「单个事务对不对」这个容易的问题,应用开发者只需要想后者。弱隔离级别给不了这句保证,所以每用一个弱隔离级别,你都得回到 §2 那几种竞争,一个一个排查自己的代码。
检查一下理解
1.(§1.1)作者为什么说「可中止性」比「原子性」更贴切? ACID 的 A 讲的不是并发时别人看不到半成品,那是 I 的事。它讲的是出错时把事务已经做的写全部丢掉,应用因此可以放心重试。
2.(§1.2)重试一个被中止的事务,什么情况下反而坏事? 事务其实已提交、只是确认在网络上丢了,重试会做两遍;错误来自过载或高竞争时,重试让情况更糟;违反约束这类永久错误,重试没用;发邮件这种数据库之外的副作用会重复发生。
3.(§2.1)防脏读,大多数数据库为什么不让读去拿锁? 一个长时间的写事务会让所有读它那几行的请求一起等,只读请求的响应时间被拖垮,一处慢还会连累别处。所以数据库记下旧的已提交值,写事务提交之前,别人读到的都是旧值。
4.(§2.2)备份和完整性检查为什么特别需要快照隔离? 它们要读很大一片数据、跑很久,期间写入照常进行。没有一致的快照,读到的是不同时刻的拼凑;备份恢复后,这种不一致(比如钱凭空少了)就永久留下了。
5.(§2.3)PostgreSQL 和 MySQL 的 repeatable read 在丢失更新上有什么不同? PostgreSQL 会自动发现丢失更新,中止后写的那个事务;MySQL 的 InnoDB 不检测。所以有作者认为,按「必须防住丢失更新」的定义,MySQL 提供的不算快照隔离。
6.(§2.4)什么是「把冲突物化」?作者为什么只把它当最后的手段? 幻读的问题是没有行可锁,那就人为造一张表,比如把每个资源、每个时间段预先建成一行,事务先锁住相应的行再检查和写入。但怎么物化很难想对、容易出错,而且让并发控制的细节漏进了业务数据模型,能用可串行化就用可串行化。
7.(§3.1)单线程串行执行为什么要求事务写成存储过程? 交互式事务的大部分时间花在应用和数据库之间来回传语句上,单线程干等就太慢了。把整段事务代码事先交给数据库,数据又都在内存里,它就能不等网络和磁盘一口气跑完。
8.(§4.4)不用跨系统的分布式事务,怎样做到每条消息恰好处理一次? 在数据库事务里先记下消息 ID,再做业务写,一起提交,之后才向消息代理确认。重投时看到 ID 已在库里,就直接确认丢弃;ID 表上的唯一约束挡住两个并发的重复处理。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 事务把一大类故障和并发问题变成「中止,再试一次」;隔离级别越弱,留给应用自己防的竞争越多。
原子性其实是可中止性 ACID 的 A 不管并发,管的是出错时把已做的写全部撤销。这样应用才敢放心重试。
§1.1 C 是应用的事 一致性指应用定义的不变式。数据库只能检查你声明成约束的那部分,其余靠你把事务写对。
§1.1 一行存好几个版本 快照隔离靠多版本:每个版本标着谁建的、谁删的,读的人按开始那一刻挑版本。读不挡写,写不挡读。
§2.2 同一个名字,好几种意思 repeatable read 在 PostgreSQL 里是快照隔离,在 MySQL 里更弱,在 Db2 里是可串行化。看文档,别看名字。
§2.2 前提变了 写偏斜:两个事务各自查条件、各自写不同的行,写完后对方的前提都不成立了。只有可串行化能自动挡住。
§2.4 悲观地等,乐观地查 两阶段锁有风险就等,一个慢事务能卡住一片;SSI 先放行,提交时发现前提过时再中止,只读查询在快照上跑,不用拿锁。
§3.3 答了「是」就不能反悔 两阶段提交靠两次承诺成立;协调者崩溃时,答过「是」的参与者只能持锁干等。
§4.1 启发式,是委婉说法 XA 的「启发式决定」让参与者自己拍板,作者直说:这多半意味着破坏原子性,只留给灾难时用。
§4.2