这一章在做什么
复制就是在几台联网的机器上各放一份相同的数据。数据不变时这很容易,难全在改动上:一次写先落到一台机器,别的副本迟早跟上,没跟上的这段时间里读的人会看到什么,机器坏了又会丢掉什么。这一章讲三种做法:所有写只进一个主库(单主),几个主库都能写(多主),读写都同时发给好几个副本(无主)。取舍落在一条线上:越不依赖单个节点,越扛得住故障和断网,代价是要你来解决冲突,一致性也更弱。
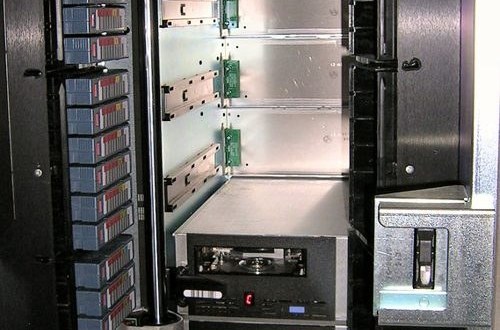
一台小型磁带库(ADIC Scalar 100)打开门后的内部,左边架上是 LTO-2 磁带盒;这台库里还留着再装四台磁带机的空位(本站裁剪)。开篇的方框先把一件事说清楚:复制替代不了备份。误删一行,删除会被原样复制到每一个副本上;想回到过去,只能靠存在别处的旧快照。Aaron Kuhn,CC BY-SA 2.0,维基共享资源 读之前:先预测
第 4 章讲一台机器上的存储引擎,这一章开始把数据放到好几台机器上,每个副本里跑的仍是那些引擎,主库甚至可以直接把预写日志发给从库。后面几章都从这里接着走:第 7 章去掉「每台机器都装得下全部数据」这个假设,讲分片;第 9 章细说这一章反复碰到的不可靠的网络和时钟;第 10 章的共识,正是自动选出新主库要解决的问题;第 12 章的变更数据捕获,用的就是这里的逻辑日志。
你在网盘的共享文件夹里上传了一个文件,主库马上回复成功。之后每秒刷新一次文件夹,读请求在两个从库之间轮流:从库 A 几乎不落后,从库 B 落后 4 秒。接下来几秒里你会看到什么?
一直看得到:主库已经说成功了,说明所有副本都写好了
前 4 秒都看不到,之后一直看得到
时有时无:轮到 A 时看得到,轮到 B 又没了,几秒后才稳定
看得到,因为浏览器记住了自己刚上传的文件
一个两地部署的仓储系统,两个区域各有一个主库,异步互相同步,冲突用「最后写入者胜」解决。两个区域的管理员几乎同时修改同一件商品的货架位置(两次修改相隔约 0.2 秒,彼此还没同步过来),两边都收到了「保存成功」。最后会怎样?
两个修改都留下,下次读的时候返回两个值让应用去挑
真正后保存的那一次一定胜出,先保存的被覆盖
同步时发现冲突,后到的那次被回滚,管理员会收到报错
时间戳大的那次留下,另一次悄悄丢掉,而时间戳大的不一定是真正后保存的
两个区域各留各的值,从此永远不一致
写总要先落到某一台机器上,别的副本总要慢一步。这一步的空档里,读的人会看到什么、机器坏了会丢掉什么?三种复制方式把「谁能收写」放在不同的地方,各自付出的代价是什么?
异步复制的主库坏了,换一个从库当主库,已经告诉用户「成功」的写为什么可能就此消失?§1.1 §1.3
复制延迟会造成哪三种怪象?每一种要靠哪一种保证挡住?§1.5
两个主库同时改了同一条记录,有哪几种收场的办法,各自丢掉了什么?§2.3
无主复制里 w + r > n 为什么通常能读到最新值,又在哪些情况下不灵?§3.1
这一章的骨架
这一章按「谁能收写」分成三大块:单主(§1)、多主(§2)、无主(§3),后两块都比第一块短,因为很多问题前面已经铺好了。容易乱的是两处:§1 里同步与异步、故障切换、日志格式、复制延迟一路排下来,前四节都是在为 §1.5 做铺垫;§2.3 的冲突解决和 §3.4 的并发检测是同一个问题的两半,隔着一大块无主复制,读到 §3.4 时要回头把它们接上。
复制:同一份数据放在几台机器上,难在改动
单主 §1
多主 §2
无主 §3
所有写只进一个主库
几个主库都能收写
直接写好几个副本
同步还是异步 §1.1
加从库、故障切换 §1.2–1.3
复制日志的格式 §1.4
复制延迟的三种怪象 §1.5
跨区域、复制拓扑 §2.1
离线与协作:同步引擎 §2.2
写冲突怎么收场 §2.3
法定人数 w + r > n §3.1
和单主比性能 §3.2–3.3
判断并发:版本向量 §3.4
同一个问题的两半
代价:主库是瓶颈
从库会读到旧数据
好处:更扛节点故障、断网和延迟尖刺
代价:要解决写冲突,一致性更弱
黄色三格是全章的重心,读到时放慢
本站画的全章结构。§1.6 只是 §1.5 的收尾,§4 是小结,图里没有单列。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
半同步:一个从库同步、其余异步,它慢了就换一个异步的顶上;全部同步的话,任何一个节点出事,写就全停。
故障切换:判定主库死亡、选新主库、让大家改认新主库;会出事的有:异步时丢写、旧主库回来还当自己是主、脑裂、超时设得不对。
日志格式:语句会遇到不确定的函数和执行顺序;预写日志太底层,和存储格式绑死;逻辑日志与引擎解耦,能跨版本。
读己之写:可能改过的从主库读;按最近一次写的时刻决定读主库;记住自己写的位置,只读追上了的副本。多设备时位置要集中保存,各设备还可能被路由到不同区域。
最后写入者胜:并发写没有先后,所谓「最后」其实是随机挑一个,其余悄悄丢掉;只插入、键不重复、从不更新时没问题。
法定人数的边界:新值的节点坏了、从旧副本恢复;再平衡途中;读和写并发;写在部分节点成功但总数不足 w;时钟不准;并发写。
版本向量:多个副本同时各自收写,一个计数器分不清谁见过谁,要每个副本一个版本号。
分节地图
全章约 1.8 万词(不算图注),建议分五次读。第二次的 §1.5 和第三次的 §2.3 是全章的重心;第四、五次讲无主复制,§3.4 的版本号例子要拿笔跟着算一遍。
第一次坐下§0–§1.3 · 约 3700 词 · 单主复制怎么搭起来,节点坏了怎么办
Replication means keeping a copy…约 600 词 开篇 复制的三个理由,三种做法的总览。方框讲复制和备份为什么不能互相替代。 Single-Leader Replication约 400 词 单主复制 主库收所有写,从库按同样顺序重放复制日志。哪些系统是这么做的。 Synchronous Versus Asynchronous Replication约 600 词 同步复制与异步复制 主库等不等从库确认:各自换来什么、丢掉什么,半同步怎么折中。 Setting Up New Followers约 900 词 添加新的从库 不停机加从库靠快照加日志位置。方框讲把数据库放在对象存储上的利弊。 Handling Node Outages约 1300 词 处理节点宕机 从库挂了怎么追上;主库挂了的故障切换分三步,留意每一步能出的事。 第二次坐下§1.4–§1.6 · 约 3300 词 · 复制日志的格式,复制延迟的三种怪象
Implementation of Replication Logs约 1000 词 复制日志的实现 语句、预写日志、逻辑日志三种格式,看它们和存储引擎绑得多紧。 Problems with Replication Lag约 2000 词 复制延迟带来的问题 读扩展只能配异步复制,于是有了三种怪象和对应的三种保证。最该细读的一节。 Solutions for Replication Lag约 300 词 复制延迟的解决办法 在应用里补,还是换一个强一致的数据库?NoSQL 和 NewSQL 的来回。 第三次坐下§2–§2.3 · 约 5100 词 · 多主复制和写冲突
Multi-Leader Replication约 300 词 多主复制 让不止一个节点收写。同步的多主等于单主,所以只讨论异步的。 Geographically Distributed Operation约 1200 词 跨地域运行 每个区域一个主库,从四个方面和单主对比;再看几种复制拓扑各自的毛病。 Sync Engines and Local-First Software约 1100 词 同步引擎与本地优先软件 离线可用和实时协作的应用,本质上都是多主复制。同步引擎的好处和适用范围。 Dealing with Conflicting Writes约 2500 词 处理写冲突 避免冲突、最后写入者胜、手动解决、自动合并。注意每种办法丢掉的是什么。 第四次坐下§3–§3.2 · 约 3000 词 · 无主复制和法定人数
Leaderless Replication约 300 词 无主复制 不要主库,任何副本都能直接收写。Dynamo 风格这个叫法的来历。 Writing to the Database When a Node Is Down约 2000 词 有节点宕机时怎么写 读写都发给多个副本:漏掉的写怎么补,w + r > n 保证什么、不保证什么。 Single-Leader Versus Leaderless Replication Performance约 700 词 单主与无主的性能对比 无主为什么更扛慢节点和灰色故障,它自己又有哪些性能问题。 第五次坐下§3.3–§4 · 约 2800 词 · 跨区域、检测并发写,加小结
Multi-Region Operation约 200 词 跨区域运行 无主数据库跨区域时怎么转发写、怎么选一致性级别。 Detecting Concurrent Writes约 1900 词 检测并发写 什么叫「并发」;用版本号分出覆盖和并发,推广到多副本就是版本向量。 Summary约 600 词 小结 全章回顾。先自己回忆一遍再读它。
先用中文过一遍
单主复制:写只进主库,从库照着日志重放
选一个副本当主库,客户端的写都发给它。主库每改一次数据,就把改动记进复制日志发给各个从库,从库按同样的顺序重放一遍;读可以落到任何一个副本上。好比一个班只有一个人记账,其他人照着这份流水抄。
关键的选择是同步还是异步。主库等某个从库确认收到了,才告诉客户端「成功」,这是同步:这个从库一定和主库一样新,可它一卡住,所有写都得停下等它。不等就是异步:写永远不会被从库拖慢,代价是主库如果在改动发出去之前坏掉,客户端已经收到「成功」的写就没了。实际系统常常折中,一个从库同步,其余异步。
主库坏了要故障切换(failover):先判断它真的死了(通常靠超时),再选一个数据最新的从库接任,最后让客户端和其他从库都改认新主库。每一步都可能出事:超时设长了,恢复得慢;设短了,负载一高就误判。旧主库回来以后如果还以为自己是主库,两个主库同时收写,就是脑裂(split brain)。
复制延迟:刚写完读不到,刷新又倒回去
大多数线上服务读多写少,于是有一种很诱人的做法:多加几个从库分摊读请求,叫读扩展。从库一多,就只能用异步复制,否则任何一个从库出问题,写就全停了。异步就有延迟:平时不到一秒,系统负载高或者网络出问题时,可能是几秒甚至几分钟。只要停止写入、等一会儿,从库终究会追上,这就是最终一致性(eventual consistency);「终究」是多久,没有上限。
延迟大了,用户会碰到三种怪象。自己刚改的东西刷新后不见了,要的保证叫读己之写(read-after-write);刷新一次,看到的比上一次还旧,像时间倒流,要的保证叫单调读(monotonic reads);有先后关系的两次写,读的人看到的顺序反了,比如先看到回复、后看到提问,要的保证叫一致前缀读(consistent prefix reads)。前两种在下面的模拟器里能直接看到。办法本身不复杂,难在应用代码里处处都得想着它。
主库
从库 B
落后好几秒
从库 A
几乎不落后
用户
时间 →
发给 B 的改动,路上走了好几秒
B 这时才改名
① 读到「草稿」
读到「终稿」
② 又是「草稿」
改名:草稿 → 终稿
① 自己刚改的读不到:违反读己之写 ② 比上一次读到的还旧:违反单调读
本站画的示意图,用的是网盘里给文件改名的例子。三次刷新都是读,只是被分到了落后程度不同的从库上;主库上的数据从头到尾都是对的。
多主:每个区域都能写,代价是冲突
单主的毛病是所有写都得经过那一个主库。数据库部署在好几个区域(几个地理上分开的数据中心)时,离主库远的用户每次写都要跨洋走一趟;连不上主库,就根本写不了。多主让每个区域都有自己的主库,写在本地完成,再异步同步给其他区域。手机上离线可用的应用、几个人同时编辑一份文档,其实也是多主:每台设备、每个浏览器标签页都是一个能收写的副本,只是网络差到了极点。
代价是冲突。两个主库同时改了同一条记录,各自都说「成功」,同步时才发现对不上。收场的办法大致有四种:从源头上避免(同一条记录只让一个主库写);比时间戳,留大的,丢掉另一个(最后写入者胜,LWW);把几个值都留下,交给应用或用户去挑;按数据类型自动合并,文本、列表、计数器都有专门的算法(CRDT 和 OT)。还有一类冲突更隐蔽:两次写各自没问题,合在一起才违反约束,比如演出的同一个座位被两个区域各卖出去一次。
甲区域管理员:改成 B-07
乙区域管理员:改成 C-03
区域甲的主库
货架 A-12 → B-07 ✓
区域乙的主库
货架 A-12 → C-03 ✓
异步同步
冲突:同一格两个新值
避免:这件商品只让
一个区域的主库写
LWW:留时间戳大的
另一个悄悄丢掉
两个都留:读到
{B-07, C-03}
改「归属」时会失效
两边的确认里有一个是假的
由应用或人来挑
文本、列表、计数器这类数据,还可以用 CRDT 或 OT 自动合并,谁的改动都不丢(§2.3)
本站画的示意图,货架编号是编的。两个管理员都收到了「保存成功」,冲突是在之后的异步同步里才发现的,这时已经没法再拒绝谁了。
无主:同时写好几个,同时读好几个
无主复制干脆不要主库:客户端(或替它跑腿的协调节点)把写同时发给 n 个副本,等到 w 个确认就算成功;读也同时问 n 个,等 r 个回复,取版本号最大的那个值。只要 w + r > n,写过的那几个副本和读到的那几个副本至少有一个重叠,读就能拿到最新值。有副本宕机也不用故障切换,只要活着的还凑得够 w 和 r。
宕机期间漏掉的写怎么补?读的时候发现某个副本的值旧了,顺手把新值写回去(读修复);别的副本先替它收着,等它回来再转交(提示移交);后台进程定期比对副本之间的差异(反熵)。书里接着列了一串「凑够了法定人数也可能读到旧值」的情形,这一段别跳过。
n = 5,w = 4,r = 2:4 + 2 > 5,所以写和读至少重叠一个副本
写 v8:等到 4 个确认就算成功(副本 5 当时宕机,没收到)
副本 1
v8
副本 2
v8
副本 3
v8
副本 4
v8
副本 5
v7(旧)
读修复
读:等到 2 个回复
副本 4 在两个集合里都有:读到 v8 和 v7,取版本大的 v8
读修复:发现副本 5 是旧的,顺手把 v8 写回去
本站画的示意图,参数是随便取的(书里的例子用 n = 3 和 n = 5,读写人数相等)。w 大、r 小适合读多写少,代价是只要有两个副本连不上,写就会失败。
这一章点名的系统
DRBD 复制的块设备 书里列举的单主复制的用户之一,复制的是磁盘块而不是数据库。
WAL-G、Litestream 备份工具 把复制日志和定期快照存进对象存储,既能做备份,也能拿来搭新从库。前者支持 PostgreSQL、MySQL、SQL Server,后者针对 SQLite。
VoltDB 数据库 用基于语句的复制,靠要求事务必须是确定性的来保证安全。
Lotus Notes 协作软件 书里说它在 1980 年代开了同步引擎的先河,只是那时还没有这个叫法。
Automerge、Yjs 同步引擎 开源后端、基于 CRDT,适合做本地优先软件。
ShareDB 同步引擎 用 OT 同步 JSON 数据。
CouchDB 文档数据库 冲突时把几个值都留下(兄弟值),交给应用去解决。
Riak 无主数据库 Dynamo 风格,用 CRDT 解决冲突;2.0 版用点版本向量判断并发。
Cassandra、ScyllaDB 无主数据库 Dynamo 风格,用时钟时间戳做最后写入者胜;跨区域的写先交给本区域的协调节点转发。
Dynamo 与 DynamoDB 名字像,架构不同 Dynamo 是亚马逊的内部系统,只发表过论文;DynamoDB 是后来的云数据库,用的是基于 Multi-Paxos 的单主复制。
英文 中文 一句话 leader / follower 主库 / 从库 主库收所有写,从库按主库的顺序重放;也叫 primary / replica 等(§1)。 replication log 复制日志 主库发给从库的改动流,从库靠它追平(§1)。 synchronous / asynchronous replication 同步 / 异步复制 主库等不等从库确认再报成功;一个同步、其余异步叫半同步(§1.1)。 failover 故障切换 主库坏了,把一个从库提升为新主库,并让所有人改认它(§1.3)。 split brain 脑裂 两个节点都以为自己是主库,同时收写(§1.3)。 logical (row-based) log 逻辑日志(按行) 按行记录增删改,和存储引擎的内部格式解耦(§1.4)。 replication lag 复制延迟 一次写在主库生效到在从库上可见之间的时间差(§1.5)。 eventual consistency 最终一致性 停止写入、等足够久,各副本终究会一致;多久没有上限(§1.5)。 read-after-write consistency 读己之写一致性 用户总能读到自己提交过的改动;对别人的改动不作承诺(§1.5)。 monotonic reads 单调读 同一个用户连续读,不会先读到新数据、再读到更旧的(§1.5)。 consistent prefix reads 一致前缀读 有先后的几次写,任何人读到的顺序都和写的顺序一样(§1.5)。 last write wins (LWW) 最后写入者胜 冲突时留时间戳最大的值,其余丢掉(§2.3)。 CRDT 无冲突复制数据类型 能把并发修改自动合并、让各副本收敛到同一状态的数据结构(§2.3)。 quorum 法定人数 读写各要多少个副本回应才算数;w + r > n 时读写集合重叠(§3.1)。 version vector 版本向量 每个副本一个版本号,合起来判断两次写是先后还是并发(§3.4)。
动手:模拟器
先猜:从库 B 落后 4 秒,读请求在 B 和 A 之间轮流(先 B 后 A)。你上传一个文件,接着连刷新 4 次,有几次看不到它?哪一次会比上一次看到的还少?勾上「读己之写」以后,同事上传的文件还会不会忽隐忽现?猜好了再动手。
模拟器 复制延迟:读到旧数据 一个共享文件夹:一个主库,两个从库。上传写进主库,刷新从从库读。每个操作算 1 秒。先点「我上传一个文件」,再连点几次「刷新文件夹」。
默认设置下,上传一个文件,连刷新 4 次。哪几次看不到自己的文件?哪一次「时间倒流」?把 B 的延迟调到 1 秒,重置后再做一遍。
重置,勾上「读己之写」,重做第一步:「改读主库」记了几次?再点「同事上传一个文件」,连刷新 3 次,同事的文件为什么还会忽隐忽现?
重置,只勾「单调读」(这里按用户固定读从库 B),上传后连刷新几次:还会倒流吗?自己的文件多久才出现?再把「读己之写」也勾上,看看这次读付出的代价在哪一格。
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(quorum、failover 这类)不在这里,在上面的术语表里。
§0 Replication means keeping a copy…
go back in time
… you can go back in time. …
回到过去(某一刻的数据状态)
备份能做到,复制做不到:副本总是紧跟着最新的状态。
§1 Single-Leader Replication
considered offensive
… it is widely considered offensive. …
被认为带有冒犯性
说的是 master–slave 这个旧叫法,现在一般说 leader / follower 或 primary / replica。
§1.1 Synchronous Versus Asynchronous Replication
hardcoded
… other systems are often hardcoded to …
写死的(不能配置)
fall behind
… followers might fall behind the leader …
落后于
impracticable
… it is impracticable for all followers …
行不通的
比 impractical(不太实际)更重:实际上就做不到。
grind to a halt
… whole system to grind to a halt. …
(整个系统)停摆、卡死
grind 是磨,像机器磨着磨着停下来。
§1.2 Setting Up New Followers
in flux
… the data is always in flux, …
一直在变
flux 本义流动,in flux 是「处在变动中」,和流量无关。
go against
… would go against our goal of …
违背
backlog
… the backlog of data changes since …
积压(还没处理的改动)
catch up
… we say it has caught up. …
追平(把积压的改动处理完)
复制里的固定说法,从库「追上」主库。和 keep up(一直跟住、不掉队)分开记。
arcane
… a somewhat arcane multistep workflow …
晦涩的、只有内行才懂的
grapple with
… must grapple with trade-offs, though. …
费力应对
grapple 本义扭打、抓住不放。
§1.3 Handling Node Outages
go down
… node in the system can go down, …
宕机、挂掉
不是「下降」。恢复是 come back(up)。
no foolproof way
… There is no foolproof way of …
没有万无一失的办法
foolproof 字面是「傻瓜也不会弄错」。
bounce back and forth
… frequently bounce messages back and forth …
来回互发
bounce 是弹来弹去,这里指节点之间不停地互发心跳消息。
step down
… have forced it to step down. …
下台、让出位置
fraught with
… Failover is fraught with things that …
充满(风险、麻烦)
after all
… weren’t durable after all. …
原来(并不)、到头来
不是「毕竟」。放在句末,表示结果和原先以为的相反。
safety catch
… As a safety catch, some …
保险装置
本义是枪上的保险栓。
glitch
… or a network glitch could cause …
小故障、短暂失灵
§1.4 Implementation of Replication Logs
break down
… it can break down in …
失效、行不通
不只是机器坏了:一种做法 break down,是它在某些情况下不成立。
work around
… It is possible to work around …
绕过(问题)
may seem like a minor detail
… may seem like a minor implementation detail …
看起来只是个小细节(其实不然)
作者先往轻里说,紧接着用 but 推翻:版本不兼容,意味着升级要停机。
§1.5 Problems with Replication Lag
realistically
… this approach realistically works only with …
实际上、现实地说
coin (a term)
… consistency was coined by Douglas Terry …
创造(一个词)
battle cry
… became the battle cry of many …
口号
本义冲锋时的呐喊。最终一致性一度成了很多 NoSQL 项目挂在嘴边的口号,带点调侃。
deliberately vague
… “eventually” is deliberately vague; …
故意说得含糊
作者的口吻:eventually 不给时间上限,是刻意的,不是疏忽。
understandably
… will be understandably unhappy. …
可以理解地(换谁都会)
negate the benefit
… negating the benefit of read scaling …
抵消好处
wouldn’t be so bad
… This wouldn’t be so bad if …
倒也没那么糟
往轻里说:先承认一种情况还能接受,再说真正让人困惑的是另一种。
a lesser guarantee
… It’s a lesser guarantee than …
较弱的保证
psychic powers
… Such psychic powers are impressive but …
未卜先知的超能力
作者的玩笑:回答出现在提问之前,看上去像能预知未来。
§1.6 Solutions for Replication Lag
a recipe for problems down the line
… a recipe for problems down the line. …
迟早要出问题的做法
a recipe for disaster 是常见说法,「注定出事的配方」;down the line 是「以后、将来某个时候」。
embrace
… would have to embrace eventual consistency. …
接受(并主动采用)
in the face of
… resilience in the face of network …
面对(困难时)
§2.1 Geographically Distributed Operation
outweigh
… the benefits rarely outweigh the added complexity. …
超过、抵得过
fare
… multi-leader configurations fare in a …
(在某种情况下)表现如何
动词 fare,不是名词「车费」。how X fares 是 X 结果怎样。
defeat the purpose
… might defeat the purpose of having …
违背初衷、让……白费
defeat 不是打败某人。部署多个区域本来为了快,写还都得跨洋,就白费了。
better off
… you’re therefore better off with a …
(选……)更好、更划算
retrofitted
… is a retrofitted feature in many …
后来加装的
本义给旧机器加装新部件:很多数据库原本没有多主复制,是后来补上的。
dangerous territory
… considered dangerous territory that should …
雷区
字面「危险地带」,意思是能不碰就别碰。
§2.2 Sync Engines and Local-First Software
taken to the extreme
… between regions, taken to the extreme. …
推到极端
每台设备就是一个「区域」,只是网络差到了极点。
albeit
… albeit one that doesn’t support …
尽管、虽然
intermittent
… mobile devices with intermittent connectivity. …
时断时续的
pioneer
… was pioneered by Lotus Notes in …
开创、率先做
carry over to
… don’t directly carry over to other …
照搬到、同样适用于
说的是一个领域的技术换到另一个领域还成不成立,不是「搬运」。
§2.3 Dealing with Conflicting Writes
in the first place
… occurring in the first place. …
从一开始就(不让它发生)
不是「第一」,强调从源头上。
coincidentally
… If the writes coincidentally have the …
碰巧
…, though
… The term is misleading, though, because …
不过
句中或句末的 though 表转折,相当于 however,不是「虽然」。
bother
… than to bother the user. …
打扰、麻烦(某人)
ready-made
… There isn’t a quick ready-made answer …
现成的
§3 Leaderless Replication
fashionable
… became a fashionable architecture for databases …
时兴的
profound
… has profound consequences for the way …
深远的
§3.1 Writing to the Database When a Node Is Down
How far can we push this?
… How far can we push this? …
能推到多远?(极限在哪)
push 是把参数往极端调:只要一个副本确认行不行?
as you see fit
… the numbers as you see fit. …
按你觉得合适的来
any number of
… or any number of other reasons. …
各种各样的、很多
不是「任何数字」。
on the upside
… On the upside, this configuration allows …
好的一面是
edge case
… confusing in certain edge cases. …
边缘情形(少见的极端情况)
§3.2 Single-Leader Versus Leaderless Replication Performance
warrant
… bad enough to warrant a failover …
值得、足以成为……的理由
动词 warrant,不是「保证书」:情况糟到值得做一次故障切换吗?
under strain
… is already under strain. …
吃紧、不堪重负
§3.4 Detecting Concurrent Writes
transient
… because of a transient outage. …
短暂的
strike sb. as
… that example strikes you as too inane, …
让人觉得
作者自嘲:嫌购物车的例子太无聊(inane),就想象一个更严肃的场景。
oblivious to
… oblivious to client 2’s write, …
完全不知道
supersede
… supersedes the prior value of …
取代
§4 Summary
that’s not even considering
… that’s not even considering the more …
这还没算上
作者在加码:光是宕机和断网就够麻烦了,更难缠的故障还没提。
insidious
… the more insidious kinds of fault, …
隐蔽而危害大的
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
答案是第三项(§1.5)。主库的「成功」只说明主库写好了,异步的从库什么时候跟上没有保证。读落到 A 时看得到,落到 B 时 B 还没收到这次写,文件就没了,下一次轮回 A 又出现。这里同时破坏了两个保证:刚上传就读不到,违反读己之写;看到过又消失,违反单调读。第二项是把两个从库想成一样慢了,只要读在副本之间换来换去,就会忽隐忽现。第四项说的是应用自己在客户端缓存,书里讨论的是数据库返回什么。想一想:如果把读请求固定发给 B,还会倒流吗?刚上传的文件要多久才出现?
答案是第四项(§2.3)。最后写入者胜给每次写打一个时间戳,同步时只留大的,另一个直接丢掉,不报错,不回滚,两个管理员都以为自己保存成功了。两次修改是并发的,谁「后」本来就没有定义,时间戳的先后基本是随机的;如果某个区域的时钟走得快,真正后保存的那次反而可能输(§2.3 讲时钟,第 9 章细说)。第一项是「保留兄弟值」的做法,不是 LWW;第五项是什么都不做的后果,LWW 恰恰能让各副本收敛到同一个值。想一想:如果这个字段换成「库存数量」,两边各扣了 3 件,LWW 会算出什么?换成自动合并的计数器呢?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
这是哪种异常?最省事的修法是什么?§1.5
场景:客服后台的读请求随机分到三个异步从库。一位客服盯着一张工单,刷新时状态一会儿是「已处理」,一会儿又变回「处理中」。工单是别的同事处理的,不是这位客服自己改的。
违反读己之写:这位客服读工单一律走主库 违反单调读:按客服的用户 ID 固定读同一个从库 违反一致前缀读:把相关的写放进同一个分片 发生了脑裂:给旧主库加上防护
先看到新状态、再看到旧状态,是「时间倒流」,要的是单调读;书里的办法是让同一个用户总从同一个副本读,比如按用户 ID 的哈希选。读己之写只管自己写过的东西,这张工单不是这位客服改的。一致前缀读说的是有因果关系的几次写顺序颠倒,这里只有一条记录的新旧。脑裂会写坏数据,不会让同一条记录在新旧之间来回跳。
这个应用该用哪种复制方式?§2.2 §2.3
场景:一个给野外勘探队用的标注应用,几个人在同一张地图上画线、加标记。山里经常一连几小时没有信号,回到营地联网后要把各人的改动合在一起,谁的标注都不能丢。
单主:所有写都发到总部的主库 无主:w = n,保证每次都读到最新值 多主,冲突用最后写入者胜 每台设备一个本地副本(同步引擎),用 CRDT 自动合并
离线也要能写,就必须让每台设备都能收写,这是多主,具体形态就是 §2.2 讲的同步引擎;谁的标注都不能丢,冲突就得自动合并而不是丢弃,CRDT 正是为此设计的。单主和 w = n 的无主都要求联网才能写。LWW 能收敛,但会悄悄丢掉并发的改动。
把超时调到 3 秒,最可能出什么事?§1.3
场景:一个订单库用单主复制,团队想让故障恢复更快,把「多久没响应就判定主库死亡」从 30 秒改成 3 秒。每逢大促,主库负载很高,响应时间偶尔会冲到 4、5 秒。
大促时可能触发不必要的故障切换,切换本身又加重负载 没有影响,主库没死就不会切换 一定会发生脑裂 恢复变快,而且没有任何代价
超时只看「多久没回应」,分不清主库是死了还是忙。负载尖峰把响应拖过 3 秒,系统就会认定主库死亡并切换;书里特别提醒,系统本来就在高负载下挣扎时,一次多余的切换只会让情况更糟。脑裂是可能的后果之一,但不是必然。
用户偶尔读到旧值,改哪一样最直接?§3.1
场景:一个 Dynamo 风格的数据库,n = 3,为了快把 w 和 r 都设成了 1。现在用户偶尔会读到几秒前的旧值。
把副本数加到 n = 5,w、r 仍是 1 关掉读修复,减少后台写 把 w 和 r 都改成 2 改用时钟时间戳决定哪个值更新
w + r = 2,不大于 n = 3,写过的副本和读到的副本可能完全不重叠。改成 w = r = 2 后 w + r > n,读写集合至少重叠一个副本,代价是每次要多等一个副本,能容忍的宕机节点也少了。加副本而 w、r 不变,重叠只会更难;关掉读修复让旧值留得更久;时间戳只决定读到几个值时选哪个,没读到新值就选不出来。
想做不停机的大版本升级,复制日志用哪种?§1.4
场景:一个 24 小时都有人下单的服务,数据库要从一个大版本升到下一个,新版本改了磁盘上的存储格式。团队希望先升级从库,再切换主库,全程不停机。
基于语句的复制 直接传预写日志 逻辑(按行)日志 先关掉复制,升级完再打开
先升级从库、再切换,要求主库是旧版本、从库是新版本时复制还能跑。逻辑日志和存储引擎的内部格式解耦,容易保持向后兼容。预写日志记的是哪个磁盘块的哪几个字节变了,存储格式一变,新旧版本就对不上。基于语句的复制有不确定函数、执行顺序的老问题,书里说很多数据库更愿意用别的方式。关掉复制就谈不上不停机切换了。
和本站其他书对照
NFS 的陈旧缓存 OSTEP 第 49 章 在一台客户端上改了文件,换一台客户端去读,读到的还是旧版本。这和从库落后造成的「读不到自己的写」是同一类问题:数据有好几份,更新传到别处要时间。NFS 用关闭时刷新和属性缓存来缓解,那一页的模拟器能看到超时参数怎样决定你读到新的还是旧的。
去那一页 → AFS 的「最后写者胜」 OSTEP 第 50 章 两台机器同时改同一个文件,AFS 保留最后关闭文件的那一份,另一份整个被覆盖。这就是 §2.3 的最后写入者胜,只不过比的是关闭的先后而不是时间戳。对照着读,能看清这种做法丢掉了什么。
去那一页 →
值得停下来的句子
one of those writes is randomly chosen to be the winner and the other writes are silently discarded— §2.3。本站译:这几次写里随机挑一个当胜者,其余的悄悄丢掉。
这是作者对「最后写入者胜」的重新定义。名字让人以为系统在尊重时间顺序,可对并发的写来说根本不存在谁先谁后,时间戳只是把随机性藏了起来。值得停下来,是因为 Cassandra、ScyllaDB 这类数据库用的就是这种办法(§3.4),用它之前要先问自己:我的应用丢得起这些写吗?
the resilience of a leaderless system comes from the fact that it doesn’t distinguish between the normal case and the failure case.— §3.2。本站译:无主系统的韧性,来自它不区分正常情况和故障情况。
单主系统平时走一条路,出了故障走另一条路(故障切换),而切换前要先判断「够不够坏」,这个判断本身就会出错。无主系统每次都同时问好几个副本、用最先到的回复,慢一个、坏一个都在日常流程里消化掉了。这句话解释了为什么无主复制特别扛「灰色故障」,也说明它的韧性和它的弱一致性来自同一个设计。
检查一下理解
1.(§0 方框)已经有三个副本了,为什么还要备份? 副本会尽快反映每一次写,包括误删。删除同样会被复制到所有副本上,复制救不回来;备份存的是过去某个时刻的快照,才能回到误删之前。
2.(§1.1)为什么不能把所有从库都设成同步? 同步意味着主库要等每个从库确认才算写成功。从库越多,任一个宕机或网络出问题的可能越大,而任何一个卡住,所有写都得停。
3.(§1.2)给正在运行的主库加一个新从库,为什么不能直接拷数据文件? 拷贝期间数据一直在变,拷出来的各部分来自不同时刻,拼不成一致的状态。要先做一个一致的快照,记下它在复制日志里的位置,新从库装好快照后从这个位置往后追。
4.(§1.3)一个从库掉线很久,主库为什么左右为难? 主库要么一直留着这个从库还没确认的日志,冒磁盘写满的风险;要么删掉,那个从库回来时就没法靠日志追,只能从备份重建。
5.(§1.4)基于语句的复制在哪几种情况下会让副本不一致? 语句里有取当前时间、随机数这类不确定的函数;语句依赖自增列或已有数据,而各副本的执行顺序不同;触发器、存储过程这类有副作用的语句,副作用不确定。
6.(§1.5)一致前缀读为什么主要是分片数据库的问题? 如果所有写都按同一个顺序应用,读到的总是某个一致的前缀。分片之后各分片独立处理写,没有全局顺序,有因果关系的两次写落在不同分片上,就可能一个先被读到、一个后被读到。
7.(§3.1)已经有读修复了,为什么还需要提示移交和反熵? 读修复只在读的时候发生,很少被读的值可能一直是旧的。提示移交让别的副本先替宕机的副本收着写,等它回来再转交;反熵在后台比对副本差异,补上剩下的漏洞,只是不保证顺序,可能很慢。
8.(§3.4)服务器只看版本号,怎么知道一次写是覆盖还是并发? 客户端写的时候带上它上次读到的版本号,表示「我是在这个版本的基础上改的」。版本号不超过它的值都已经被合并进新值,可以覆盖;比它大的是客户端没见过的,属于并发写,要保留成兄弟值。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 复制的难处全在改动:单主让读的人看到延迟,多主和无主让写的人碰上冲突,没有哪一种能两头都躲开。
复制不是备份 误删一行,删除会被原样复制到每个副本。想回到过去,得靠存在别处的旧快照。
§0 说了成功也会丢 异步复制下主库突然坏掉,新主库可能还没收到最后几次写;旧主库回来后,这些写通常直接扔掉。
§1.3 超时两头难 判定主库死亡的超时设长了,恢复慢;设短了,负载一高就误切换,切换本身又让局面更糟。
§1.3 刷新一下倒回去 两次读落到落后程度不同的从库,第二次比第一次还旧。让同一个用户固定读一个从库就能挡住。
§1.5 「最后」是假的 最后写入者胜,其实是在并发写里随机挑一个留下,其余悄悄丢掉;时钟一偏,真正后写的反而输。
§2.3 不分平时和故障 无主系统本来就同时问好几个副本,慢一个就用别人的回复,从来不用判断要不要故障切换。
§3.2 带着版本号来写 写的时候带上读到的版本号,服务器就知道这次写覆盖了谁、和谁并发,用不着看值本身。
§3.4