这一章在做什么
程序在内存里用对象和指针,写文件、发网络之前要先变成一串字节。这一章先比几类编码:语言自带的序列化、JSON 这类文本格式、带模式的二进制格式(Protocol Buffers 靠标签号,Avro 靠写者和读者两份模式)。真正的考题是演化:滚动升级和迟迟不更新的客户端,让新旧代码、新旧数据长期并存,编码要两个方向都读得通。后半看数据经过数据库、服务调用、工作流和消息时,谁写谁读,各要哪个方向的兼容。
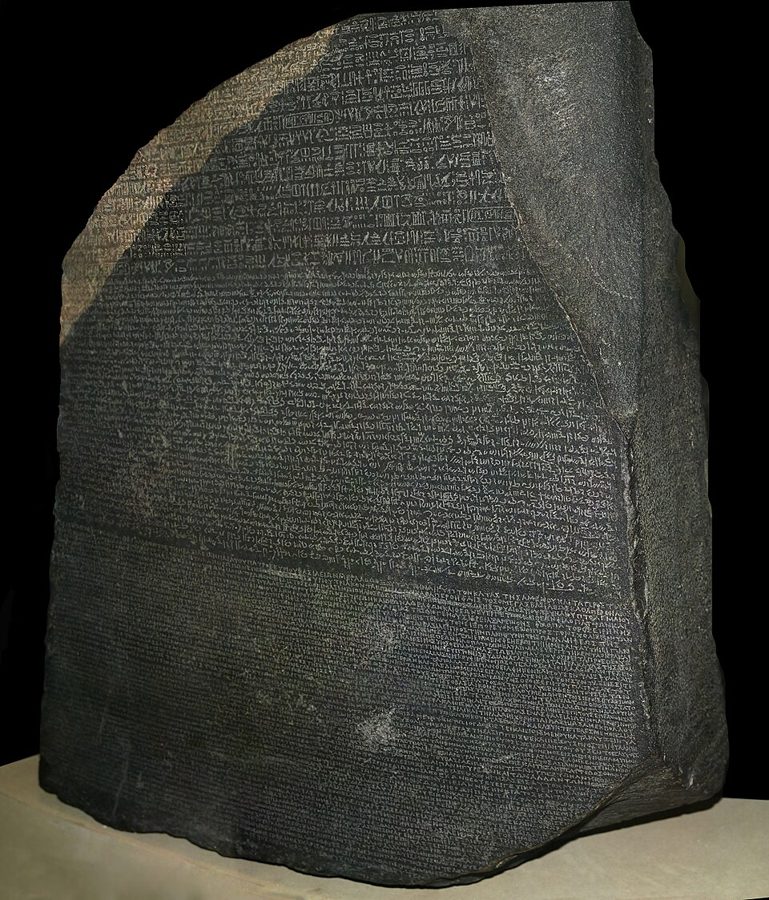
罗塞塔石碑,现藏大英博物馆。上面是公元前 196 年的一道诏令,用古埃及象形文字、世俗体和古希腊文各刻了一遍。1799 年被发现时,象形文字早已没人会读,学者拿认得的希腊文对照,Champollion 在 1822 年宣布破解。照片与本书无关,只是一个类比:数据往往比读它的程序活得久,要读懂它,得知道它当初是按什么规则写的。Hans Hillewaert,CC BY-SA 4.0,维基共享资源 读之前:先预测
第 2 章提出了「可演化性」:系统要容易改。第 3 章说文档数据库在读的时候才解释结构(schema-on-read),关系数据库在写的时候就强制模式。这一章把「改」落到字节上:数据一旦写下或发出,读它的程序可能比写它的新,也可能比它旧。第 4 章的 LSM 合并在这里也露了一面:它顺手把旧数据改写成新格式。往后看,第 9 章接着讲超时和确定性重放,第 11 章会再用到 Avro 这类大文件,第 12 章细讲消息代理和幂等。
一个订单服务用 Protocol Buffers 编码,新版本给订单加了字段 coupon(用一个新的标签号)。滚动升级进行到一半:一台新实例写了一条带 coupon 的订单;接着一台还没升级的旧实例把它读出来,改了状态,写回数据库。新代码再读这条订单,coupon 还在吗?
不在,也走不到这一步:旧代码读到不认识的标签就报错
一定丢了:旧代码的模式里根本没有 coupon
要看旧代码把记录解码成对象时,有没有把不认识的字段一起留着、写回时原样带上
一定还在:写回时只改了状态,别的字段数据库不会动
换成 Avro:新模式加了一个字段 vip,没有给默认值。新旧代码同时在跑,哪个方向会读不了?
旧代码读新数据:它不认识 vip
新代码读旧数据:旧数据里没有 vip,新模式又没给默认值
两个方向都会坏
两个方向都没事:Avro 按字段名对上,多出来的跳过,缺了的不管
新旧代码、新旧数据会在系统里并存很久,没法一次全换掉。一种编码格式要有什么样的规矩,系统的各个部分才能各自升级,又不会互相读坏、写丢?
为什么说向前兼容比向后兼容难?除了「忽略不认识的字段」,旧代码还得做到什么?§0
在 Protocol Buffers 里,字段名和标签号哪个能改、哪个绝不能动?删掉的字段为什么要把标签号留着?§1.3
Avro 的数据里没有任何标识,读的一方凭什么知道每一段是什么?§1.4
数据经过数据库、经过服务调用、经过消息代理,各自要哪个方向的兼容?§2.1 §2.2 §2.4
这一章的骨架
这一章分两半:§1 讲怎么把数据编码成字节,一种格式一种格式地比,落点是它们怎么对待模式的变化;§2 换个角度,讲字节在进程之间怎么流动,每一种流法里谁编码、谁解码、谁先升级。容易乱的是 §1.3 和 §1.4:两种格式都「带模式」,但兼容的规矩完全不同,一个靠数字,一个靠名字加默认值。读的时候把两套规矩分开记。
新旧代码、新旧数据同时存在 §0
怎么把数据变成字节 §1
字节在进程之间怎么流 §2
语言自带的序列化:绑死语言 §1.1
JSON、XML、CSV:类型含糊 §1.2
按标签号:Protocol Buffers §1.3
写者模式 + 读者模式:Avro §1.4
带模式有什么好处 §1.5
经过数据库:写给将来的自己 §2.1
经过服务:REST 与 RPC §2.2
经过工作流:持久执行 §2.3
经过消息:消息代理与 actor §2.4
每一种都问:谁编码、谁解码、谁先升级
贯穿全章:向后兼容(新代码读旧数据)· 向前兼容(旧代码读新数据)
左边决定「能不能」兼容,右边决定「要哪个方向」的兼容
本站画的全章结构。黄色两格是全章最密的地方,也是模拟器演示的内容。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
文本格式的坑:超过 253 的整数在 JavaScript 里丢精度,只好再附一份字符串;二进制通常转成 Base64,体积大约多三分之一。
标签号的规矩:新字段用新号;删掉的号永远不再用,可以在模式里保留;改类型可能被截断。
Avro 的规矩:只能加、删有默认值的字段;改名靠读者模式里的别名,所以新读旧行、旧读新不行。
写者模式来源:大文件在开头写一次;数据库里每条记录带版本号,去模式库里查;网络连接建立时双方协商。
不重写旧数据:读的时候把缺的列填成默认值(如 null),重写推迟到合并之类的时机,尽力而为。
RPC 的毛病:结果不可预测、可能超时不知结果、重试会重复执行、延迟忽高忽低、参数要编码、跨语言类型要转换。
持久执行代价:重放要求按同样顺序发出同样的调用,改顺序就出问题;新代码单独部署,已有实例继续用旧版本。
分节地图
全章约 1.1 万词(不算代码和图注),建议分四次读。第二次(Protocol Buffers 和 Avro)最需要慢读,最好边读边玩下面的模拟器;第三次里 §2.2 很长,但负载均衡那一段和兼容的主线关系不大,可以读快些。
第一次坐下§0–§1.2 · 约 2500 词 · 为什么要两个方向的兼容,文本格式的毛病
Applications inevitably change over time.…约 700 词 开篇 新旧代码为什么会同时在跑;向后、向前兼容的定义;旧代码把新字段写丢的风险。 Formats for Encoding Data约 300 词 编码数据的格式 内存里的结构和字节序列两种表示,编码和解码这对词的几个别名。 Language-Specific Formats约 300 词 语言自带的格式 Java、Python 自带的序列化方便在哪,又有哪几个深层问题。 JSON, XML, and Binary Variants约 1300 词 JSON、XML 和它们的二进制变体 文本格式在数字、二进制上的含糊;JSON Schema 的开放与封闭;二进制 JSON 省了多少。 第二次坐下§1.3–§1.5 · 约 2900 词 · 两种带模式的二进制编码,全章的重心
Protocol Buffers约 900 词 Protocol Buffers(协议缓冲区) 标签号代替字段名;加字段、删字段、改类型时各守什么规矩。 Avro约 1600 词 Avro 格式 数据里只有值。写者模式和读者模式怎么对上,写者模式从哪来,为什么适合自动生成的模式。 The Merits of Schemas约 400 词 模式的好处 老想法 ASN.1;带模式的二进制编码比 JSON 多给了什么。 第三次坐下§2–§2.2 · 约 3400 词 · 数据经过数据库和服务
Modes of Dataflow约 200 词 数据流动的几种方式 兼容是编码方和解码方之间的关系。后面按数据怎么流来分。 Dataflow Through Databases约 600 词 经过数据库的数据流 写数据库就是给将来的自己发消息;新旧格式的数据混在一起时数据库怎么办。 Dataflow Through Services: REST and RPC约 2600 词 经过服务的数据流:REST 与 RPC Web 服务和接口定义;远程调用为什么不该装成本地调用;服务发现;接口怎么演化。 第四次坐下§2.3–§3 · 约 2100 词 · 工作流和事件,加小结
Durable Execution and Workflows约 800 词 持久执行与工作流 一笔支付要调好几个服务。持久执行怎么做到「只执行一次」,代价是什么。 Event-Driven Architectures约 900 词 事件驱动的架构 消息代理比直接调用多了什么;两种分发方式;分布式 actor 框架。 Summary约 400 词 小结 全章回顾。先自己回忆一遍再读它。
先用中文过一遍
两个方向的兼容:新旧代码会一起跑很久
改一个功能,常常要给数据加个字段。可代码不能一瞬间全部换掉:服务端通常滚动升级(rolling upgrade),一次换几台,看没出事再换下一批,这期间新旧版本同时在线;手机上的 App 更新不更新,由用户说了算。所以系统里总有新代码在读旧数据,也总有旧代码在读新数据。
前一种叫向后兼容(backward compatibility),比较好办:写新代码的人知道旧格式长什么样,专门处理就行。后一种叫向前兼容(forward compatibility),难在旧代码写的时候还不知道将来会多出什么。它至少要能跳过不认识的字段;更进一步,旧代码读出一条记录、改了一处再写回去时,还得把那些不认识的字段原样带上,否则新代码写进去的东西就被它悄悄抹掉了。
滚动升级的某一刻:新旧版本同时在跑
实例 1
旧版本
新版本
实例 2
实例 3
实例 4
手机 App
用户没更新,一直是旧版本
此刻:两新、两旧,外加旧 App
时间 →
共享的数据库
新实例写、旧实例读:
要向前兼容
旧实例写、新实例读:
要向后兼容
旧实例改完写回时:
别把新字段写丢
本站画的示意图。浅色格是旧版本代码,蓝色格是新版本。滚动升级做完之前,任何时刻都可能是这种混合状态。
同一条记录,四种写法:字段名、标签号,还是什么都不写
把一条记录编码成字节,最直接的是 JSON:每条记录都把字段名写一遍,人能看懂,体积也大,而且数字不分整数和浮点,没有二进制类型。二进制的 JSON 变体(如 MessagePack)把类型和长度换成字节,省得不多,因为字段名还在。
Protocol Buffers 要求先写模式,模式里给每个字段编一个号(标签号,field tag)。编码时只写「标签号 + 类型 + 值」,字段名根本不进数据,所以字段可以随便改名,标签号却一个也不能动。旧代码读到一个不认识的标签号,靠类型信息知道该跳过几个字节。
Avro 更进一步:数据里只有一个接一个的值,连标签号都没有。要解码,必须拿着写这份数据时用的那份模式(写者模式,writer's schema),按它的字段顺序一段段往下读。读的程序还有自己期望的模式(读者模式,reader's schema),两者可以不同,Avro 按字段名把它们对上:写者有、读者没有的字段跳过,读者有、写者没有的字段填读者模式里的默认值。于是兼容的规矩变成了「默认值」的规矩。
JSON:42 字节,每条记录都带着字段名
buyer
lin.w
seat
B12
price
380
二进制 JSON(如 MessagePack):31 字节,字段名还在
buyer
lin.w
seat
B12
price
380
按标签号(Protocol Buffers):15 字节
1
5
lin.w
2
3
B12
3
380
1、2、3 是模式里的标签号(和类型挤在一个字节里),
5、3 是字符串的长度
Avro:12 字节,只有长度和值
5
lin.w
3
B12
380
没有写者模式,就不知道哪一段是什么:
380 这两个字节也可能被当成别的类型
字段名
类型、标签号或长度
值
本站画的示意图:一张票(买家 lin.w,座位 B12,票价 380)的四种编码,一格宽度是一个字节。JSON 那条里引号、冒号和逗号也算在字节里。字节数是本站按各格式的规则算的,可以拿模拟器下面的数字对照。
数据怎么流:判断方向只看读的一方是新还是旧
兼容总是两个进程之间的事:一个编码,一个解码。数据经过数据库时,写的进程编码、读的进程解码,读的人可能是将来的自己,也可能是还没升级的另一台实例。数据经过服务调用时,请求由客户端编码、服务端解码,响应反过来。书里给服务调用做了一个简化的假设:服务端先升级,客户端后升级。在这个假设下,请求只要向后兼容,响应只要向前兼容。经过消息代理时,发送方编码、接收方解码,中间的代理不管格式。
§2.2 后半有一段要单独留心:远程过程调用(RPC)想让一次网络请求看起来和本地函数调用一样。作者用一整串理由说明这条路为什么走不通,其中「超时之后不知道对方做没做」和「重试可能做两遍」会在后面几章反复出现。
常见顺序:服务端先升级
反过来:新客户端调旧服务端
旧客户端
新服务端
请求
响应
请求:新代码读旧客户端写的
→ 向后兼容
响应:旧客户端读新代码写的
→ 向前兼容
新客户端
旧服务端
请求
响应
请求:旧服务端读新客户端写的
→ 向前兼容
响应:新客户端读旧服务端写的
→ 向后兼容
规律:读的一方比写的一方新,要向后兼容;比它旧,要向前兼容
本站画的示意图。蓝色是新版本。书里对服务调用的简化假设是左边那种顺序;右边那种情况,书在 §0 讲 API 的兼容时也列了出来。
这一章点名的系统
Protocol Buffers 二进制编码库 Google 开发,先写模式再生成各语言的代码,数据里用标签号代替字段名。
Apache Thrift 二进制编码库 最初由 Facebook 开发,书里说讲 Protocol Buffers 的内容大多也适用于它。
Apache Avro 二进制编码格式 2009 年作为 Hadoop 的子项目起步,数据里不带标签号,靠写者模式和读者模式解码。
MessagePack 二进制 JSON 把 JSON 编成更紧凑的字节,字段名仍然写在数据里。
JSON Schema 模式语言 给 JSON 规定类型和取值约束;默认允许模式里没写的字段出现。
OpenAPI 服务接口定义 又叫 Swagger,描述收发 JSON 的 Web 服务的端点和数据模型。
gRPC RPC 框架 用 Protocol Buffers 写服务定义,再生成服务端骨架和客户端代码。
Temporal 工作流引擎 提供持久执行:把每次调用记进日志,失败后重放时跳过已经成功的步骤。
Confluent Schema Registry 模式注册表 和 Kafka 搭配,存各个模式版本、检查兼容性,书里举它作按版本号查写者模式的例子。
Istio、Linkerd 服务网格 书里说在 Kubernetes 这类变化频繁的环境里常用,负责负载均衡、加密和观测。
英文 中文 一句话 encoding / decoding 编码 / 解码 内存里的结构和字节序列之间的转换。也叫序列化、反序列化,书里避开这个词,因为第 8 章它另有所指(§1)。 rolling upgrade 滚动升级 一次只给几个节点换新版本,看没问题再往下换,不停服(§0)。 backward compatibility 向后兼容 新代码能读旧代码写的数据(§0)。 forward compatibility 向前兼容 旧代码能读新代码写的数据(§0)。 schema evolution 模式演化 模式随时间改变,同时保持两个方向的兼容(§1.3)。 field tag 标签号 Protocol Buffers 模式里给每个字段编的号,编码时代替字段名(§1.3)。 writer’s schema 写者模式 Avro 里编码这份数据时用的那一版模式,解码时必须拿到(§1.4)。 reader’s schema 读者模式 读数据的程序期望的模式,可以比写者模式新或旧(§1.4)。 union type 联合类型 Avro 里一个字段可以是几种类型之一;想让字段可为空,就要把 null 列进去(§1.4)。 IDL 接口定义语言 描述数据结构或服务接口的语言,工具据此生成代码和文档(§1.3、§2.2)。 RPC 远程过程调用 让网络请求看起来像调用本地函数的做法(§2.2)。 location transparency 位置透明 调用方看不出对方在本地还是在远程(§2.2)。 idempotence 幂等 同一个操作做一次和做多次,结果一样;重试安全的前提(§2.2)。 durable execution 持久执行 记下工作流里每一步的调用和结果,失败后重放,已成功的步骤不再真的执行(§2.3)。 message broker 消息代理 发送方和接收方之间暂存消息的中间件(§2.4)。
动手:模拟器
先猜:按标签号编码,新模式删掉 seat、加一个字段 vip,而且 vip 用回 seat 留下的标签 2。新代码读一条旧数据,会报错吗?如果不报错,读出来的 vip 是什么?猜好了,在模拟器里依次点「删字段 seat」「加字段 vip」「vip 用 seat 的旧标签 2」验证。
模拟器 模式演化:新旧代码能不能互读 旧模式描述一张票:买家 buyer、座位 seat、票价 price。用上面一排按钮把它改成新模式,看新代码读旧数据、旧代码读新数据各读出什么,再看旧代码改了票价写回之后,新字段还在不在。先从「加字段 vip」开始。
按标签号:点「加字段 vip」,看两个方向各读出什么;再取消「旧代码保留不认识的字段」,看最后一行,旧代码写回之后 vip 去哪了。
换成按字段名:加字段 vip,不勾「vip 带默认值」,哪个方向坏了?勾上再看。然后点「删字段 seat」,勾不勾「旧模式里 seat 带默认值」差在哪?同样的操作在按标签号的编码下为什么一直不报错?
「price 改名 amount」在两种编码下各会怎样?留意下面的字节数:改名之后,二进制的字节数变了吗?JSON 的呢?
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(schema evolution、idempotence 这类)不在这里,在上面的术语表里。
§0 Applications inevitably change over time.…
work your way through
… working your way through all the nodes …
一个一个地推进,直到做完
work one’s way through 是「一点点挨个过一遍」,和「工作」无关。
at the mercy of
… you’re at the mercy of the user, …
只能听凭……摆布
客户端什么时候升级,开发者说了不算。
intact
… to keep the new field intact, …
原封不动的
§1 Formats for Encoding Data
overload a word
… To avoid overloading the word, …
让一个词身兼几个意思
和函数「重载」是同一个词。serialization 在第 8 章讲事务时另有意思,所以作者改用 encoding。
a myriad
… there are a myriad libraries and …
数不清的
§1.1 Language-Specific Formats
commit oneself to
… committing yourself to your current programming language …
把自己绑定在……上
不是 git 的 commit,是「许下承诺、从此脱不了身」。
preclude
… and precluding integrating your systems …
使……不可能、排除
afterthought
… Versioning data is often an afterthought …
事后才补上的东西
设计时没考虑,出了问题才想起来。下一段又用了一次。
notorious for
… is notorious for its bad performance …
因……而出了名(坏名声)
bloated
… bad performance and bloated encoding.
臃肿的
transient
… other than very transient purposes.
临时的、转瞬即逝的
§1.2 JSON, XML, and Binary Variants
contender
… JSON and XML are the obvious contenders: …
(明摆着的)候选者
本义是参赛者、竞争者;这里指「首先会想到的那几个选项」。
superficial
… Besides the superficial syntactic issues, …
表面的、不触及实质的
get around
… people get around this limitation …
绕过(限制)
hacky
… it’s somewhat hacky and increases …
凑合的、不太体面的
程序员说的 hack 常指「能用但不优雅的临时招数」,不是「黑客攻击」。
good enough
… are good enough for many purposes.
够用
言下之意是「谈不上好,但够用」。
outweigh
… anything outweighs most other concerns.
比……更要紧
作者在打趣:让几家机构对任何事达成一致都太难,格式好不好看反倒是小事。
make for
… Such features also make for unwieldy definitions.
造成、导致
make for 在这里不是「朝……走去」。unwieldy 是笨重、难驾驭。
a profusion of
… a profusion of binary encodings for JSON …
大量涌现的
to name a few
… and Smile, to name a few) …
仅举几例
前面列了八个,还说只是「举几个」,言下之意这类格式多得是。
niche
… been adopted in various niches, …
小众领域、特定场合
in case you’re wondering
… In case you’re wondering what happens …
你要是好奇的话
不是「以防」,是作者顺手回答读者可能冒出来的问题。
§1.3 Protocol Buffers
spell out
… having to spell out the field name.
完整写出来
spell out 不只是「拼写」,常指「一五一十地写明」。
§1.4 Avro
a good fit for
… not being a good fit for …
适合
could just as well be
… could just as well be an integer …
同样也可能是
just as well 在这里是「同样可能」;it’s just as well that… 才是「幸好」。
gloss over
… We’ve glossed over an important question: …
一笔带过、略过不谈
negate
… negating all the space savings from …
抵消、化为乌有
aforementioned
… avoid the aforementioned problems with textual formats …
前面提到的
§1.5 The Merits of Schemas
by no means
… are by no means new.
绝不是、一点也不
viable
… are also a viable option.
可行的
diverge from reality
… may easily diverge from reality) …
和实际情况对不上
文档写一回事,代码早就是另一回事了。
concurrent
… the number of concurrent schema formats …
同时并存的
不是「并发」:指同一时期在用的几种模式格式。
§2.1 Dataflow Through Databases
your future self
… sending a message to your future self.
将来的你自己
比喻:今天写进数据库的东西,是留给明天升级后的程序读的。
outlive
… summed up as data outlives code.
比……活得久
代码几分钟就换完了,五年前写的数据还按当年的格式躺着。
on a best-effort basis
… asynchronously and on a best-effort basis.
尽力而为(不打包票)
remains a research problem
… migrations remains a research problem.
还是个没解决的研究课题
说得很克制,意思是眼下没有现成的好办法。
§2.2 Dataflow Through Services: REST and RPC
at least in theory
… access any website (at least in theory!).
至少理论上如此
括号里加感叹号是作者在打趣:实际上并不总是这样。
misnomer
… is perhaps a slight misnomer, …
名不副实的叫法
叫 web service,却不只用在网页上。
incarnation
… merely the latest incarnation of a long line …
(同一类东西的)最新化身
言下之意:Web 服务是一长串同类技术里最新的一个,前面那些大多热闹过一阵,后来都暴露出严重的问题。
hype
… received a lot of hype but …
炒作、热捧
plagued by
… are also plagued by complexity …
饱受……之苦
wildly
… its latency is also wildly variable: …
极其、剧烈地
程度副词,不是「野蛮地」。
there’s no point
… there’s no point trying to make …
做……没有意义
best served with
… are best served with software load balancers.
最适合用……
be best served by/with 是「用……最合适」,不是「被服务得最好」。
§2.3 Durable Execution and Workflows
not without its challenges
… Temporal are not without their challenges.
也有不少难处
双重否定往轻里说,实际意思是「问题不少」,后面紧接着就列了几条。
brittle
… This makes code changes brittle; …
脆弱的、一碰就坏的
§2.4 Event-Driven Architectures
sends it and forgets about it
… simply sends it and then forgets about it.
发出去就不管了
行话叫 fire-and-forget。
landscape
… the landscape of message brokers was dominated …
格局、整体面貌
不是「风景」。
§3 Summary
with a bit of care
… with a bit of care, …
稍加小心
May your …
… May your application’s evolution be rapid …
祝你的……
May 放在句首是祝愿句式,「愿……」,不是「也许」。
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
书里的答案是第三项(§0、§1.3)。Protocol Buffers 的旧代码读到不认识的标签号不会报错:每个字段带着类型,解析器知道跳过几个字节,也能把这些字节留着。但能不能活到写回,要看应用把记录解码成什么:如果解码成一个只认识旧字段的对象,写回时 coupon 就没了。作者希望的行为是旧代码原样保留新字段,即使它看不懂。§2.4 又提了一次:消费者把消息转发到别的主题时,同样要留住不认识的字段。想一想:如果换成 Avro,旧代码用自己的模式解码、再用自己的模式写回,结果会一样吗?(模拟器里可以试。)
书里的答案是第二项(§1.4)。Avro 按字段名对上:旧代码读新数据时,vip 只出现在写者模式里,跳过就行;新代码读旧数据时,读者模式要 vip,写者模式里没有,只能用读者模式里的默认值,可偏偏没给,于是读不了。所以书里的规矩是:只能加、删有默认值的字段。很多人直觉以为坏的是「旧读新」,因为「旧代码不认识新字段」听起来更危险。想一想:如果是删掉一个没有默认值的字段,坏的是哪个方向?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
每天导出的数据该用哪种格式?§1.1 §1.4
场景:一个票务系统每天凌晨把 MySQL 里的几十张表导出成文件,给数据团队分析。业务改得勤,表结构每周都在加列、删列;导出程序想从表结构自动生成编码用的模式,不想每次手工维护。
用 Java 自带的序列化,导出程序本来就是 Java 写的 Protocol Buffers:每次加列时给新列分配下一个标签号 Avro:每次运行都从表结构生成模式,列名直接当字段名 CSV,再附一份手写的列说明文档
书里专门拿这个场景说明 Avro 的长处:模式里没有标签号,字段按名字对上,导出程序每次从表结构重新生成模式就行,读的一方照样能和旧模式对上。用 Protocol Buffers 就得有人维护「列名到标签号」的对应,还不能把用过的号再分出去。Java 自带的序列化把数据绑死在 Java 上,数据团队未必用 Java;CSV 没有模式,加删列都要手工处理,手写的文档也容易和实际脱节。
这次故障最可能的原因是什么?§1.3
场景:会员服务用 Protocol Buffers 存会员档案。半年前删掉了字段 referrer(推荐人的用户 ID,标签 7)。这周新加字段 nickname,开发顺手用了空着的 7。上线后没有任何报错,但一批老会员的昵称显示成了一串用户 ID。
新旧服务用的 protobuf 库版本不一致 新字段复用了删掉字段的标签号,老数据里标签 7 的值被当成昵称读了出来 nickname 没有默认值,新代码读老数据时出错 字段改了名,旧代码按名字找不到
数据里只有标签号,没有字段名。老档案里标签 7 存的是推荐人 ID,新代码按新模式把 7 解释成昵称,类型又都是字符串,所以一声不吭地读错了。书里的规矩是删掉的标签号永远不能再用,可以在模式里把它保留起来防止有人忘记。Protocol Buffers 里改名本来就不影响数据;proto3 的字段缺了就填类型的默认值(空字符串、0),不会因为默认值报错。
按书里的假设,这次接口改动需要哪种兼容?§2.2
场景:公司内部的库存服务被二十个下游服务调用。这次要给查询响应加一个字段 warehouse,给请求加一个可选参数 region。照惯例,库存服务自己先上线,下游各团队再陆续升级。
请求和响应都只要向后兼容 请求要向前兼容,响应要向后兼容 只要响应向后兼容,请求不用管 请求要向后兼容,响应要向前兼容
服务端先升级,所以有一段时间是新服务端处理旧客户端的请求(新代码读旧数据,向后兼容),旧客户端读新服务端的响应(旧代码读新数据,向前兼容)。书里正是做了「服务端先升级、客户端后升级」这个简化假设。加可选参数、给响应加字段,通常被认为是不破坏兼容的改动,前提是旧客户端会忽略响应里不认识的字段。
网页上的订单号为什么偶尔对不上?§1.2
场景:订单号是 64 位整数,接口用 JSON 数字返回。后端日志里的订单号都对,网页前端显示的订单号却偶尔末几位不一样,而且只发生在号码特别大的订单上。
大于 253 的整数被 JavaScript 当成双精度浮点数解析,丢了精度;接口应同时给出字符串形式 数据库的 bigint 溢出了 JSON 里的中文字符把字节对齐打乱了 接口用了 gzip 压缩,解压时出错
JSON 不区分整数和浮点数,也不规定精度。JavaScript 用双精度浮点数存数字,超过 253 的整数没法精确表示。书里举的例子是一家大网站的帖子 ID:接口里每个 ID 写两遍,一遍数字一遍字符串。后端日志是对的,说明数据库没溢出;JSON 是文本,没有字节对齐;gzip 出错会整个解析失败,不会只错末几位。
怎么改这个工作流最安全?§2.3
场景:退款流程用持久执行框架写成工作流,眼下有几千个实例在跑,有的停在人工审核上,要等好几天。你想在「扣回积分」和「退款到卡」之间插一步风控检查。
直接改工作流代码,重启执行器,所有实例都走新流程 直接改代码,但给风控检查生成一个随机的请求 ID,免得重复 把改动作为新版本部署:已经在跑的实例继续用旧代码,新触发的才用新代码 先把所有在跑的实例取消,再上线新代码
持久执行靠重放恢复:它记下每次调用的顺序和结果,重放时要求代码按同样的顺序发出同样的调用。往中间插一步,正在跑的实例一重放就对不上。书里的建议是新代码单独部署,已有实例继续用旧版本。随机 ID 是另一个坑:工作流代码要确定性,随机数要用框架提供的版本。全部取消会让几千笔退款中途停下,要人工收拾。
值得停下来的句子
the five-year-old data will still be there, in the original encoding, unless you have explicitly rewritten it since then.— §2.1。本站译:五年前的数据还会在那里,还是当初的编码,除非你后来特意把它重写过。
这句话把「兼容」从一个部署期间的临时问题,变成了一个长期问题。代码几分钟就能全部换掉,所以容易以为新旧并存只是升级那一阵子的事;数据不会自己升级,它让「新代码读旧数据」成了每一天都在发生的事。§2.1 后面讲数据库怎么靠读时填默认值、合并时顺手重写来应付,都是从这句话出发的。
there’s no point trying to make a remote service look too much like a local object in your programming language— §2.2。本站译:想让远程服务看起来太像你编程语言里的一个本地对象,是没有意义的。
这是作者对几十年 RPC 技术的判断。前面列的每一条差别(超时、重试、延迟、参数编码、类型转换)单看都是工程细节,合起来说明网络调用是另一种东西。留意作者的措辞是「太像」:不是不要 RPC 框架,而是别让它把网络的失败方式藏起来。第 9 章还会接着讲这些失败。
检查一下理解
1.(§0)服务端和客户端,各是什么原因让新旧代码同时存在? 服务端常用滚动升级,一次换几个节点,换完之前新旧版本同时在线。客户端要等用户自己安装更新,旧版本可能用很久。
2.(§1.1)语言自带的序列化,除了绑死一种语言,还有什么更危险的问题? 解码时要能实例化任意的类。攻击者如果能让程序解码一段他构造的字节,就可能借此在服务器上执行任意代码。
3.(§1.2)把二进制数据塞进 JSON,常见做法是什么?代价是什么? 转成 Base64 文本,再靠模式说明这个字段要按 Base64 解。能用,但不太体面,数据大约变大三分之一。
4.(§1.3)为什么字段名可以改,标签号却不能改? 编码后的数据里只有标签号,从不出现字段名,改名不影响任何已有数据。标签号一改,所有已经写下的数据就对不上号了。
5.(§1.4)在 Avro 里给字段改名,为什么是向后兼容而不是向前兼容? 新的读者模式可以给新名字加上旧名字作别名,读旧数据时按别名对上。旧代码的读者模式里没有新名字,读新数据时找不到这个字段。
6.(§2.1)关系数据库加一个默认为空的列,为什么不用重写整张表? 旧行照旧存着,读的时候发现缺这一列,就当它是 null 填上。整个库看起来像是用同一个模式写的,底下其实混着各个时期的编码。
7.(§2.2)一个网络请求超时了,为什么不能直接重试了事? 超时只说明没收到响应,不知道请求到没到、做没做。可能对方已经做完、只是响应丢了,重试就会做第二遍,除非协议里有去重(幂等)的机制。
8.(§2.4)消息代理比直接调用接收方多了哪些好处?说出三个。 接收方忙或不在时能当缓冲;接收方崩溃后能重新投递;发送方不用知道接收方的地址;同一条消息能发给好几个接收方;发送方和接收方在逻辑上解耦。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 新旧代码和新旧数据总会并存,编码格式的价值,在于让读的一方无论比写的一方新还是旧,都读得通、不写丢。
新读旧,旧读新 向后兼容是新代码读旧数据,向前兼容是旧代码读新数据。判断要哪一种,只看读的一方比写的一方新还是旧。
§0 别把新字段写丢 旧代码读、改、写回一条新记录时,要把看不懂的字段原样带上。解码成只认识旧字段的对象,新数据就悄悄没了。
§0 标签号是命根子 Protocol Buffers 的数据里只有标签号。字段名随便改,标签号不能改;删掉的号永远不再用。
§1.3 两份模式 Avro 的数据里只有值。解码要拿着写者模式,再按字段名对到读者模式上,缺了的填默认值。所以只能加、删有默认值的字段。
§1.4 数据比代码活得久 代码几分钟换完,五年前的数据还按当年的格式躺着。数据库靠读时填默认值,免得一改模式就重写全部数据。
§2.1 超时之后不知道 本地调用要么返回要么抛异常;网络请求还可能超时,你不知道对方做没做,重试可能做两遍。
§2.2 重放不能换顺序 持久执行靠按原顺序重放来跳过做过的步骤。改工作流代码要另起版本,已经在跑的实例继续走旧代码。
§2.3