这一章在做什么
数据库只做两件事:你给它数据,它存下来;你来要,它找出来。第 3 章从用的人这边看这两件事,这一章换到数据库这边。前半讲事务型(OLTP)的两派存储引擎:日志结构的 LSM 树只追加、在后台合并;B 树把磁盘分成固定大小的页,原地改写。中段讲分析型的列式存储、压缩和查询执行,最后是空间、全文和向量索引。读的时候抓一条线:每一种结构都在拿写的代价换读的速度,或者反过来。
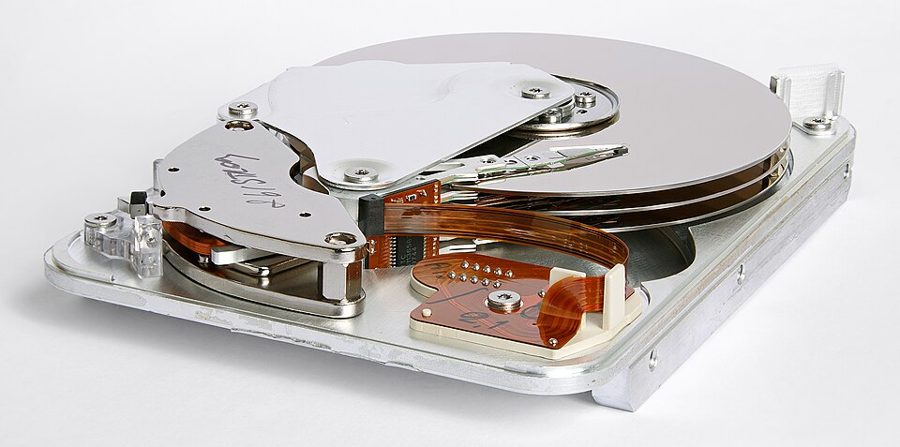
一块 1998 年产的 3.5 英寸机械硬盘,外壳打开了。读写头要靠机械臂摆到位置,再等盘片转过来,所以零散的随机写比成片的顺序写慢得多。这一章的很多设计,都是在绕开这个物理限制(§1.3 的方框讲了 SSD 上的情况)。Eric Gaba,CC BY-SA 3.0,维基共享资源 读之前:先预测
第 3 章讲数据长什么样、怎么查;这一章看数据库怎么把它存到盘上、再找回来。后面几章都站在这一章上面:第 6、7 章把数据复制、分片到多台机器,每台机器里跑的还是这一章的存储引擎;第 8 章的崩溃恢复和快照,靠的是这里的预写日志和不可变的文件;第 11 到 13 章的「派生数据」,从这里的索引和物化视图起步。
同一台机器、同一块 SSD,负载是大量随机键的写入、很少读。用 LSM 树的存储引擎和用 B 树的存储引擎,谁能扛住更高的写入吞吐?主要原因是什么?
B 树更高:它直接改原地那一页,一次写到位,不用后台再合并
LSM 树更高:它把写攒起来,成整个文件地顺序写出去,而且不用为改几个字节写整页
差不多:SSD 没有机械臂,顺序写和随机写一样快
LSM 树更高:它的数据主要放在内存里,很少写磁盘
Redis、VoltDB 这类内存数据库比基于磁盘的数据库快。书里说,快的主要原因是哪一个?
读的时候不用访问磁盘
写的时候根本不写磁盘
不用把内存里的数据结构编码成能写到磁盘上的格式
它们用了更先进的索引结构
它们只当缓存用,丢了数据也没关系,所以可以省掉很多检查
在磁盘上,「写得快」和「找得快」互相拉扯:最快的写是往文件末尾追加,最快的找要求数据按某种顺序摆好。一个存储引擎怎么在两者之间选位置?为什么事务型和分析型的选择截然不同?
LSM 树把零散的写变成了成片的顺序写。省下来的代价被挪到了哪里?§1.1 §1.3
B 树为什么非要一个预写日志?它防的是哪一种崩溃?§1.2
一个分析查询只用五六列,却要扫几十亿行。列式存储省下的是什么?为什么压缩在列上特别有效?§2.2
全文检索为什么也能看成一种「多维」查询?§3.1
这一章的骨架
这一章按「谁在查」分成三块:事务型的点查和小写入(§1),分析型的大扫描(§2),一次按好几个条件找(§3)。容易乱的是 §1:LSM 树、B 树各讲一大段,然后才在 §1.3 正面比较,中间夹着布隆过滤器、合并策略、预写日志这些零件。先认准两派,再把零件挂到各自名下。
存储引擎:存进去,找回来
事务型:点查、小写入 §1
分析型:扫很多行 §2
按多个条件找 §3
只追加:LSM 树 §1.1
原地改:B 树 §1.2
两派正面比较 §1.3
索引里放什么 §1.4–1.5
全放进内存 §1.6
云数仓拆成几个部件 §2.1
按列存、压缩、排序 §2.2
编译或向量化执行 §2.3
预先算好:物化视图 §2.4
拼接索引、空间索引 §3
全文:倒排索引 §3.1
语义:向量索引 §3.2
贯穿全章:写的代价 ⇄ 读的速度 ⇄ 占的空间
每一格都问:省了什么,付在哪
本站画的全章结构。左列是读这一章最花力气的部分,§1.3 是两派的对照表,读到那里要能把前两格的零件对上号。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
LSM 的代价:读可能要查好几个段,旧值和删掉的值占着空间直到合并;布隆过滤器帮读,后台合并回收空间。
B 树的保险:页分裂要同时改好几页,改一半就崩溃会留下孤立页或撕裂的页;先写预写日志并 fsync,重启时按日志恢复。
选哪一派:LSM 偏写多、B 树偏读多;但基准测试对负载细节很敏感,要拿你自己的负载测。
索引里放什么:聚集索引把整行放在索引里;堆文件方案里索引只存位置;覆盖索引多存几列,让某些查询不用回表。
列式的写:先写进内存里按行排好序的存储,攒够了再批量和磁盘上的列文件合并成新文件。
数据立方:某些汇总查询直接查表就有结果;但不在维度里的条件(比如按单价筛选)就答不了。
分节地图
全章约 1.3 万词(不算代码和图注),建议分四次读。第一次和第二次是全章的重心;第三次换到分析型,节奏轻一些;第四次的几种索引彼此独立,可以挑着读。
第一次坐下§0–§1.1 · 约 3500 词 · 从两行 bash 的数据库走到 LSM 树
On the most fundamental level, a…约 300 词 开篇 为什么应用开发者也要懂存储引擎;全章的路线:事务型两派,再到分析型和多维索引。 Storage and Indexing for OLTP约 600 词 面向事务处理的存储和索引 一个只追加的文件当数据库:写极快、读极慢。引出索引和它对写的代价。 Log-Structured Storage约 2600 词 日志结构的存储 从内存哈希表到有序文件,再到内存表、刷盘、合并、墓碑和布隆过滤器。全章最密的一节。 第二次坐下§1.2–§1.6 · 约 4000 词 · B 树、两派对照、索引里放什么、内存数据库
B-Trees约 1300 词 B 树 固定大小的页组成的树:查找、插入时的页分裂、预写日志,和几种变体。 Comparing B-Trees and LSM-Trees约 1600 词 B 树和 LSM 树的比较 读、顺序写与随机写、写放大、磁盘空间四个角度。留意每一条后面的保留。 Multicolumn and Secondary Indexes约 200 词 多列索引和二级索引 二级索引的键可以重复,两种处理办法。 Storing Values Within the Index约 400 词 把值存在索引里 索引的值放整行、放位置,还是放几列:聚集索引、堆文件、覆盖索引。 Keeping Everything in Memory约 500 词 全放在内存里 内存数据库怎么保证不丢数据,以及它到底快在哪。 第三次坐下§2–§2.4 · 约 3600 词 · 分析型的存储和执行
Data Storage for Analytics约 200 词 面向分析的数据存储 数据仓库和事务型数据库表面相似,内部越走越远。 Cloud Data Warehouses约 500 词 云数据仓库 云上的数仓把计算和存储分开;开源数仓拆成查询引擎、存储格式、表格式、目录四块。 Column-Oriented Storage约 1700 词 列式存储 按列存、位图编码和游程编码、选排序键、批量写入。这一块的重心。 Query Execution: Compilation and Vectorization约 600 词 查询执行:编译与向量化 扫几百万行时,CPU 也成了瓶颈。两种提速的路子,以及它们共同利用的 CPU 特性。 Materialized Views and Data Cubes约 500 词 物化视图和数据立方 把常用的汇总预先算好存起来,好处和局限。 第四次坐下§3–§4 · 约 2400 词 · 一次按好几个条件找,加小结
Multidimensional and Full-Text Indexes约 500 词 多维索引和全文索引 拼接索引为什么答不了地图上的矩形查询,空间索引怎么答。 Full-Text Search约 600 词 全文检索 倒排索引、n 元组索引、按编辑距离容错。注意它和前面位图、LSM 的联系。 Vector Embeddings约 800 词 向量嵌入 语义检索把文档变成向量,再找最近的几个:平铺、IVF、HNSW 三种向量索引。 Summary约 500 词 小结 全章回顾。先自己回忆一遍再读它。
先用中文过一遍
LSM 树:写只追加,读查好几层,后台慢慢合并
最快的写是往文件末尾追加。LSM 树想保住这一点,又想让数据有序、好找。它的办法是分两步:写先进内存里一个有序的结构(内存表,memtable),同时追加到磁盘上的预写日志,防止断电丢了内存里的东西;内存表写满了,就整个按顺序写成一个磁盘文件(一个「段」,格式叫 SSTable)。段一旦写好就不再改。
读的时候从新往旧找:先内存表,再最新的段,一直找到最旧的。段越积越多,读就越慢,旧值和删掉的值也一直占着空间,所以后台要不停地把几个段合并成一个,像归并排序那样,同一个键只留最新的值。删除也是一次写:写一条「墓碑」,合并时遇到它就把这个键的旧值扔掉。为了少读几个段,每个段带一个布隆过滤器,能很快回答「这个键一定不在这个段里」。
写入
预写日志:只追加,防断电
内存表:内存里,按键有序
满了就整个写成一个段
段 3(最新)不可变
段 2
段 1(最旧)
布隆过滤器
布隆过滤器
布隆过滤器
读一个键
读的顺序:
① 内存表
② 段 3 ③ 段 2 …
每个段先问过滤器:
「一定没有」就跳过
后台合并:几个段 → 一个新段,旧值和墓碑扔掉
本站画的示意图。左边是写路径,右边是读路径。合并在后台进行,合并期间读照常走旧的段,合并完再切换。
B 树:固定大小的页,原地改写,靠日志兜底
B 树也让键有序,但思路相反:把磁盘切成固定大小的页(几 KB),页里放一串键和指向下一层页的「页号」,组成一棵很矮的树。查一个键,从根页往下走三四层就到了存数据的叶子页。改一个值,就找到那一页、整页覆盖写回原处。
麻烦在于插入时页满了:要把它分成两页,再去改父页加一个边界;父页也满了就继续往上分。一次插入可能要改好几页,改到一半断电,树就坏了。所以 B 树配一个预写日志(WAL):任何修改先追加写进日志并刷盘,再去改树里的页;重启时按日志把树恢复到一致的状态。文件系统里同样的东西叫日志(journaling)。
插入 4100 之前(假设一页最多放 3 个键)
插入之后
根:3000 | 6000
1200 2500
3100 4700 5200
6400 7700
这一页满了
根:3000 | 4700 | 6000
1200 2500
3100 4100
4700 5200
6400 7700
分成两页,根页多一个边界
预写日志:先把「这次要改哪三页、改成什么」追加写盘(fsync),再去改页
改到一半断电:重启时按日志重做,不会留下没有父页的孤立页,也不会留下写了一半的页
本站画的示意图,键是随便取的订单号。真实的 B 树一页能放几百个键,所以三四层就够装下绝大多数数据库。
按列存:分析查询只读用得到的那几列
事务型查询一次读写几行,整行挨在一起存最方便。分析查询反过来:一张一百多列的大表,一次只用四五列,却要扫几十亿行。按行存的话,为了那几列也得把整行从盘上读出来、解析一遍。列式存储把每一列单独存,查询只读它要的列。同一列的值类型相同、经常重复,压缩起来效果很好;再按常用的条件(比如日期)给整行排个序,第一排序列会出现长长的重复段,压得更小,按日期范围查时也只用读一小段。
按行存(事务型)
按列存(分析型)
日期 城市 骑手 分钟 金额
10-01 杭州 R17 32 18
10-01 杭州 R05 25 22
10-01 苏州 R17 41 15
10-02 杭州 R09 28 30
一行挨在一起:取一单的全部信息很快
算「每天平均配送分钟」也得读整行
日期
城市
骑手
分钟
金额
10-01 10-01 10-01 10-02
杭州 杭州 苏州 杭州
R17 R05 R17 R09
32 25 41 28
18 22 15 30
只读这两列;第 k 个值在每一列里都属于第 k 行
日期列按顺序排好后全是重复段,压缩到很小
本站画的示意图,数据是编的。真实的列存会把表按几千到几百万行切成块,每块里各列分开存。
一次按好几个条件找
B 树和 LSM 树都是一维的:按一个键排好序,能快速找一个范围。把两列拼成一个键(先按姓、再按名)也只能先用第一列缩小范围。地图上找一个矩形里的餐馆,要同时限制纬度和经度,就需要专门的空间索引(R 树一类),把相近的点分在同一棵子树里。全文检索可以看成维度极多的查询:每个词是一维,用倒排索引把「词 → 包含它的文档列表」存起来,找同时含两个词的文档,就是把两个列表求交集。向量检索再进一步:先用模型把文档变成一串浮点数(向量),再找离查询向量最近的几个,用的是专门的近似算法。
这一章点名的系统
RocksDB 嵌入式存储引擎 LSM 树的代表,书里多次拿它举例,包括写入太快时的背压。
LMDB 嵌入式存储引擎 B 树的一种变体:改页时写到新位置(写时复制),不用预写日志。
SlateDB 存储引擎 书里举的例子:把 LSM 的段文件直接写到对象存储上。
DuckDB 嵌入式分析数据库 单机、嵌入式,用列式存储。
Parquet 列式文件格式 书里列举的数据湖存储格式之一,文件写好后不再修改。
Apache Iceberg 表格式 规定哪些文件组成一张表,让不可变的文件也能支持增删行。
Trino 查询引擎 解析 SQL、生成执行计划,去对象存储上的文件里查数据。
Lucene 全文检索库 Elasticsearch 和 Solr 底下的索引引擎,词到文档列表的映射存在类似 SSTable 的文件里。
pgvector PostgreSQL 扩展 在 PostgreSQL 里做向量检索,支持 IVF 和 HNSW 两种索引。
英文 中文 一句话 log 日志 只追加的记录序列。书里说的不是给人看的应用日志(§1)。 index 索引 从主数据派生出来的额外结构,让读更快、让写更慢(§1)。 SSTable 有序字符串表 按键排好序、每个键只出现一次的文件,分块并带稀疏索引(§1.1)。 memtable 内存表 写先进的内存有序结构,写满了刷成 SSTable(§1.1)。 compaction 合并(压实) 后台把几个段合成一个,丢掉被覆盖和删掉的值(§1.1)。 tombstone 墓碑 表示「这个键删了」的特殊记录(§1.1)。 Bloom filter 布隆过滤器 一个位数组,能肯定地说「不在」,只能大概地说「在」(§1.1)。 LSM-tree LSM 树 日志结构合并树:只追加、后台合并有序文件的存储引擎(§1.1)。 B-tree B 树 固定大小的页组成的平衡树,原地改写(§1.2)。 write-ahead log (WAL) 预写日志 改数据之前先追加写盘的日志,用来崩溃恢复(§1.2)。 write amplification 写放大 实际写盘的字节数除以应用要写的字节数(§1.3)。 clustered index 聚集索引 整行数据直接存在索引里(§1.5)。 covering index 覆盖索引 索引里多存几列,某些查询只查索引就够(§1.5)。 column-oriented storage 列式存储 每一列的值存在一起,而不是每一行(§2.2)。 inverted index 倒排索引 从词到「包含它的文档列表」的映射(§3.1)。
动手:模拟器
先猜:内存表一次装 3 个键,连续随机写 20 次、一次也不合并,再查一个最早写入、之后没再改过的键,要读几个段?合并一次之后呢?关掉布隆过滤器,查一个从没写过的键(u11、u12 随机写不会碰到),又要读几个?猜好了再动手。
模拟器 LSM 树:写入、刷盘与合并 写几个键,看它们怎么从内存表变成磁盘上的段;再查一个键,看它依次查了哪几层。键是 u01 到 u12,值是写入的序号。
容量调到 3,点四次「随机写 5 个」,不合并。查一个最早写过、后来没再写的键,数一数读了几个段。合并后再查一次。
关掉布隆过滤器,查 u11;再打开查一次。被跳过的段是怎么判断出来的?偶尔「读了也没找到」是怎么回事?
写 u05,再删 u05,刷盘,然后查 u05:为什么查到墓碑那一段就停了?合并之后墓碑去哪了?写放大这个数字为什么一直往上走?
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(compaction、quorum 这类)不在这里,在上面的术语表里。
§0 On the most fundamental level, a…
under the hood
… is doing under the hood. …
在内部、在底层
字面是「在引擎盖下面」,指使用者看不见的内部机制。技术英文里极常见。
§1 Storage and Indexing for OLTP
incur overhead
… additional structures incurs overhead, especially on writes …
带来额外开销
incur 是「招致(成本、损失)」,常和 cost、overhead、penalty 搭配。
hard to beat
… it’s hard to beat the performance …
很难比它更好
beat 在这里是「胜过」:论写入性能,什么都比不过直接追加。
§1.1 Log-Structured Storage
seek to
… seek to that location, and read …
(把读写位置)移到文件里的某处
不是「寻找」,是文件操作的术语,对应 lseek 这类系统调用;机械硬盘上还意味着读写头真的要移动。
fiddly
… hash collisions require fiddly logic.
繁琐、费事的
start afresh
… the unfinished SSTable and start afresh.
从头再来
rule of thumb
… As a rule of thumb, you …
经验法则
粗略好用、不保证精确的估算。这一章出现了好几次,每次都别当成定律。
consult
… we have to consult the sparse index …
查(索引、表)
consult 不只是「咨询」,查资料、查表都用它。
no harm is done
… but otherwise no harm is done …
没什么坏处、不碍事
a cascade of
… keeping a cascade of SSTables that …
一层接一层的……
cascade 本义是小瀑布、一级级往下流,这里形容一层层越来越大的 SSTable。
§1.2 B-Trees
stand the test of time
… B-trees have stood the test of time …
经受住了时间的考验
that’s where the similarity ends
… But that’s where the similarity ends; …
相似之处到此为止
用来转折:前面说了一点相同,后面要讲的全是不同。
in stark contrast to
… This is in stark contrast to …
和……截然相反
stark 是「鲜明、毫不掩饰」,不是「僵硬」。
orphan page
… an orphan page that is not …
孤立页(没有父页指向它的页)
orphan 本义孤儿。技术里常说 orphan process、orphan record。
torn page
… is known as a torn page …
撕裂的页(只写了一半的页)
tear 的过去分词,不是「眼泪」。
§1.3 Comparing B-Trees and LSM-Trees
either/or choice
… it’s not a strict either/or choice …
非此即彼的选择
keep up with
… process cannot keep up with incoming writes.
跟上(不至于落后)
an eternity
… an eternity in computing timescales.
(在计算机的时间尺度上)长得像永远
往大里说的修辞:几毫秒对 CPU 来说是几百万个时钟周期。
overtake
… have now overtaken HDDs for many …
超过、取代
wear
… contribute to wear on the flash memory;
磨损
名词 wear 是「损耗」;同一段的 wear out the drive 是「把盘用坏」。
§1.4 Multicolumn and Secondary Indexes
resolve a reference
… used to resolve such references.
解析引用(顺着 ID 找到它指的那条记录)
resolve 不是「解决」,和 DNS 解析域名的 resolve 是一个意思。
§1.5 Storing Values Within the Index
cover the query
… index is said to cover the query) …
覆盖这个查询(查询要的列索引里都有)
§1.6 Keeping Everything in Memory
awkward to deal with
… disks are awkward to deal with.
不好对付、用起来别扭
the argument is eroded
… the cost-per-gigabyte argument is eroded.
这条理由站不住了
erode 本义侵蚀:内存越来越便宜,「磁盘每 GB 更便宜」这个理由被一点点削弱。
counterintuitively
… Counterintuitively, the performance advantage of in-memory …
和直觉相反的是
§2 Data Storage for Analytics
slicing and dicing
… as drill-down and slicing and dicing) …
切片和切块(按不同维度切分数据来看)
slice and dice 本是切菜。drill-down 是「往下钻」,从汇总数一层层看到明细。
on the surface
… On the surface, a data warehouse …
表面上看
提示后面要说「其实不然」。
happen to be
… which happen to be accessible through …
恰好、碰巧
作者的口吻:两套引擎只是「碰巧」共用一个 SQL 入口,内部已经各走各的。
§2.1 Cloud Data Warehouses
established
… Established data warehouse vendors such as …
老牌的、早已站稳脚跟的
break apart
… have begun to break apart.
拆分成几个独立的部件
不是「坏掉」:原来一个系统包办的事,现在由几个组件分别做。
§2.2 Column-Oriented Storage
by convention
… data warehouses by convention often use …
按惯例
lend itself to
… often lends itself very well to compression.
很适合(做某事)
字面是「把自己借给」,意思是天然适合。
a fair amount of
… There’s a fair amount of repetition …
相当多的
fair 在这里是「不少」,不是「公平」。
jumbled up
… will be more jumbled up and thus …
更杂乱
a win overall
… sorted is a win overall.
总体上是划算的
win 当名词,「有好处的做法」。
amortize the cost
… amortizes the cost of rewriting those columns …
分摊成本
一次批量写很多行,重写列的成本平摊到每一行上就小了。
§2.3 Query Execution: Compilation and Vectorization
say,
… is greater than, say, 15.
比如说
say 插在句中,举一个随便取的例子。
tight inner loop
… work in tight inner loops …
紧凑的内层循环(指令少、不调用函数)
tight 是「紧凑」,不是「紧张」。
§2.4 Materialized Views and Data Cubes
on the fly
… underlying query on the fly and …
临时、在执行的当下
crunch through
… crunching through the raw data every time …
一遍遍地硬算(大量数据)
crunch numbers 是「做大量计算」。
§3.1 Full-Text Search
go beyond the scope of
… go beyond the scope of this …
超出……的范围
§3.2 Vector Embeddings
tell by looking
… We can tell by looking that …
一看就能看出
tell 在这里是「分辨、判断出」。
§4 Summary
get to the bottom of
… tried to get to the bottom of how …
弄清楚……的究竟
school of thought
… two main schools of thought:
流派、一派思路
armed with
… being armed with this knowledge …
掌握了(某种知识或工具)
armed 是「武装起来的」,比喻有了趁手的东西。
make sense of
… make sense of the documentation …
看懂、理解
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
书里的答案是第二项(§1.3)。LSM 树把内存表和合并的结果整段写出去,磁盘看到的是少量大块的顺序写;B 树改哪一页就写哪一页,键一分散,写也跟着分散。SSD 上差距比机械硬盘小,但仍然明显,因为闪存要整块擦除,零散的写让固态盘内部的垃圾回收更忙。另一半理由是写放大:B 树每份数据至少写两次(日志一次、树页一次),有时只改几个字节也得写整页;LSM 树不写整页、还能压缩,通常写放大更低。作者同时提醒:对空的 LSM 树做压测会高估它,合并还没开始抢带宽。想一想:如果负载换成读多写少、大量范围查询,答案会怎么变?
书里的答案是第三项(§1.6),而且作者特意说这和直觉相反:基于磁盘的数据库只要内存够大,操作系统的页缓存早就把常用的块放在内存里了,读并不碰磁盘。内存数据库省掉的,是把内存里的数据结构编码成磁盘格式的那层开销。它们也写磁盘(日志、快照),只是读完全从内存走。想一想:数据量涨到内存的十倍时,这个优势还剩多少?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
这个平台该用哪种存储引擎?§1.1 §1.3
场景:一个充电桩监控平台,几万个桩每 5 秒上报一次状态,写入量很大;读很少,主要是运维偶尔查某个桩最近一小时的记录。
B 树:读得稳,查最近一小时快 LSM 树,用按大小分层(size-tiered)的合并策略 LSM 树,用分级(leveled)的合并策略 纯内存数据库,不写磁盘,写最快
写多读少,正是 LSM 的长处;书里的经验法则是写多读少时 size-tiered 更合适,因为大部分数据只在几次大的顺序合并里被重写。leveled 读更省、占空间更少,适合读多的负载。不落盘的内存数据库重启就丢数据,监控记录丢不起。
延迟尖刺最可能的原因是什么?§1.3
场景:一个用 RocksDB 存数据的服务,平时很平稳。每天凌晨批量导入时,写延迟会周期性地飙到几秒,这几秒里连读请求也卡住,导入结束就恢复。
布隆过滤器的误判率太高,读要多查很多段 B 树的页分裂一路分裂到了根 合并跟不上写入,内存表满了,引擎暂停读写等它刷盘 二级索引太多,每次写都要改好几棵树
书里专门讲了这种情况:写入太快、合并跟不上,内存表满了刷不下去,RocksDB 这类引擎会施加背压,暂停所有读写,直到内存表写到盘上。布隆过滤器误判只会让读稍慢,不会卡住写;RocksDB 是 LSM 引擎,没有 B 树的页分裂;索引多会让写普遍变慢,而不是周期性地连读一起卡住。
怎么让这条查询少一次回表?§1.5
场景:订单表的主键是订单号。一条很热的查询是「按用户 ID 查他所有订单的状态和金额」,现在 user_id 上有一个二级索引,索引里存的值是主键,查到之后还要再按主键去找整行。
在 user_id 的索引里附带存上状态和金额两列(覆盖索引) 把整张表改成按 user_id 聚集存放 给 user_id 的索引加一个布隆过滤器 把订单表换成列式存储
覆盖索引正是为这种情况:索引里多存查询要的几列,查询只查索引就有结果,不用再去主键索引或堆文件里找。代价是多占空间、写更慢。改聚集方式影响整张表的主键布局,一张表通常只能有一个聚集索引;布隆过滤器只回答「在不在」;列式存储适合分析型的大扫描,不适合这种按用户查几行的点查。
这张表的排序键选哪个?§2.2
场景:一张 50 亿行、120 列的配送记录宽表,用列式存储。最常见的查询是「最近 7 天、某个城市、按小时汇总配送时长」。
先按骑手 ID 排 先按配送时长排 不排,按写入的先后存 先按日期排,日期相同再按城市排
第一排序键选最常用的范围条件:按日期排,查最近 7 天只用读一小段,而且日期列排序后全是长长的重复段,压缩效果最好;第二排序键按城市,让同一天同一城市的记录挨在一起。按写入顺序存大致也按时间,但同一天里各城市混在一起;按骑手或时长排,对这条查询帮不上忙。
附近的充电桩为什么查得慢?§3
场景:地图应用要显示屏幕范围内的所有充电桩,查询条件是纬度在一个区间、经度也在一个区间。数据库在(纬度, 经度)两列上建了一个拼接的 B 树索引,查询还是很慢。
索引的列顺序反了,改成(经度, 纬度)就好 建一个覆盖索引,把桩的名称也放进去 拼接索引只能先按纬度缩小范围,经度只能逐条过滤;要换成空间索引 改用全文索引,把坐标当成词
拼接索引按第一列排序,只能先用纬度把范围缩小,剩下的整条纬度带上所有经度的桩都要逐条检查;换个顺序也只是换一个方向的问题。书里给的办法是 R 树一类的空间索引,或者用空间填充曲线把二维位置变成一个数。覆盖索引省的是回表,不是扫描;全文索引不处理数值范围。
和本站其他书对照
日志结构文件系统 OSTEP 第 43 章 书里说 LSM 树建立在更早的日志结构文件系统之上。OSTEP 那一章从文件系统的角度讲同一个想法:所有写都追加到日志末尾,再靠后台的段清理回收空间,那里的段清理器就是这一章的合并。
去那一页 → 崩溃一致性和日志 OSTEP 第 42 章 B 树的预写日志,在文件系统里叫 journaling。OSTEP 那一章有模拟器,能看到改到一半崩溃会出什么事、日志怎么救回来。
去那一页 → 闪存 SSD OSTEP 第 44 章 §1.3 的方框说 SSD 上随机写仍然比顺序写慢,原因是按块擦除和垃圾回收。OSTEP 那一章把固态盘内部的这套机制讲全了。
去那一页 →
值得停下来的句子
well-chosen indexes speed up read queries, but every index consumes additional disk space and slows down writes, sometimes substantially.— §1。本站译:选得好的索引能加快读查询,但每个索引都要占额外的磁盘空间,也会拖慢写入,有时拖得很厉害。
这句话是全章的总纲。后面每一种结构,LSM 树、B 树、列存的排序、数据立方,都是在这句话划出的那条线上选一个位置。所以数据库默认不替你把所有列都建上索引,选哪几个,要看你的查询长什么样。
Counterintuitively, the performance advantage of in-memory databases is not due to the fact that they don’t need to read from disk.— §1.6。本站译:和直觉相反,内存数据库的性能优势并不是因为它们不用从磁盘读数据。
值得停下来,是因为它纠正了一个几乎人人都有的直觉。基于磁盘的数据库在内存够大时也不怎么读盘,操作系统的缓存替它做了。真正的差别在「数据怎么组织」:为磁盘设计的结构要能编码成字节、按页摆放,这层转换本身就有成本。
检查一下理解
1.(§1)为什么说索引是从主数据「派生」出来的?这对写入意味着什么? 索引删了、重建了,数据库的内容不变,只影响查询快慢。但每次写数据都要顺带更新每一个索引,所以索引越多写越慢。
2.(§1.1)只靠一个内存哈希表加只追加的日志,有哪几个问题让它不够用? 旧值永远不回收,盘会写满;哈希表不落盘,重启要扫整个日志重建;键太多内存放不下;范围查询只能一个个键去查。
3.(§1.1)内存表里的数据还没刷盘时机器断电了,数据会丢吗? 不会。每次写在进内存表的同时追加到磁盘上一个单独的日志,重启时用它恢复内存表;内存表刷成 SSTable 之后,对应的那段日志就可以丢掉。
4.(§1.1)布隆过滤器说「在」,为什么还要去读这个段? 它只能肯定地说「不在」。说「在」可能是误判:这个键要检查的那几位碰巧被别的键置成了 1。误判的代价只是多读一个段。
5.(§1.2)一个四层、页大小 4 KiB、分支因子 500 的 B 树能存多少?这说明了什么? 书里算的是最多约 250 TB。说明 B 树很矮,找任何一个键只要读几页,读的性能稳定、可预测。
6.(§1.3)为什么说 LSM 树也不是删了就真删了?这在什么场合是个问题? 删除只是写一条墓碑,旧值还躺在更早的段里,要等墓碑一路合并下去才真正消失,可能要很久。需要确认数据确实删掉的场合(比如为了遵守数据保护法规)就成了问题。
7.(§2.2)列式存储为什么不能每一列各自排序? 列存靠「第 k 个值属于第 k 行」把各列对上。各列各排各的,这个对应关系就没了,没法拼回一行。所以要整行一起排序,只是按列存。
8.(§3.1)倒排索引和本章前面的哪两样东西是同一个思路? 文档列表可以表示成位图,找同时含两个词的文档就是两个位图做按位与,和列存里的位图查询一样;Lucene 把词到文档列表的映射存在类似 SSTable 的有序文件里,后台用日志结构的方式合并。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 存储引擎都在「写得快」和「找得快」之间选位置:LSM 树偏写,B 树偏读,列存为大扫描而生。
两行 bash 的数据库 一个只追加的文件:写快得没法再快,读要从头扫到尾。全章所有结构,都是在这两个极端之间找位置。
§1 内存表、段、合并 写先进内存里的有序表,满了整个写成不可变的段,后台再把段合并。删除也是一次写:一块墓碑。
§1.1 只会说「一定没有」 布隆过滤器每个键大约 10 位就能把误判率压到 1%。说「不在」就跳过一个段,说「在」也可能是误会。
§1.1 改页之前先写日志 B 树原地改页,分裂一次要改好几页,改到一半断电树就坏了。所以任何修改先写进预写日志并刷盘。
§1.2 别拿空库做压测 空的 LSM 树还没开始合并,磁盘带宽全给新写入,测出来的吞吐偏高。要跑得够久,让写放大显形。
§1.3 内存数据库快在哪 不是因为不读盘,磁盘数据库有页缓存也不怎么读盘;是因为省掉了把数据结构编码成磁盘格式的开销。
§1.6 按日期排第一 列存按最常用的范围条件排序:查询只扫一小段,第一排序列全是重复段,压缩得最小。
§2.2