这一章在做什么
应用里的数据,最后要装进一种通用的形状:表、JSON 文档、顶点和边组成的图、一串不可变的事件,或者数据框和矩阵。这一章把它们摆在一起比,顺带看查它们的语言。主线是数据之间的关系:一对多的树放进文档最顺,多对一、多对多要靠 ID 和连接,关系四通八达时用图。另外两条线:模式由数据库在写入时检查,还是由代码在读取时解释;写的形状和读的形状要不要分开。
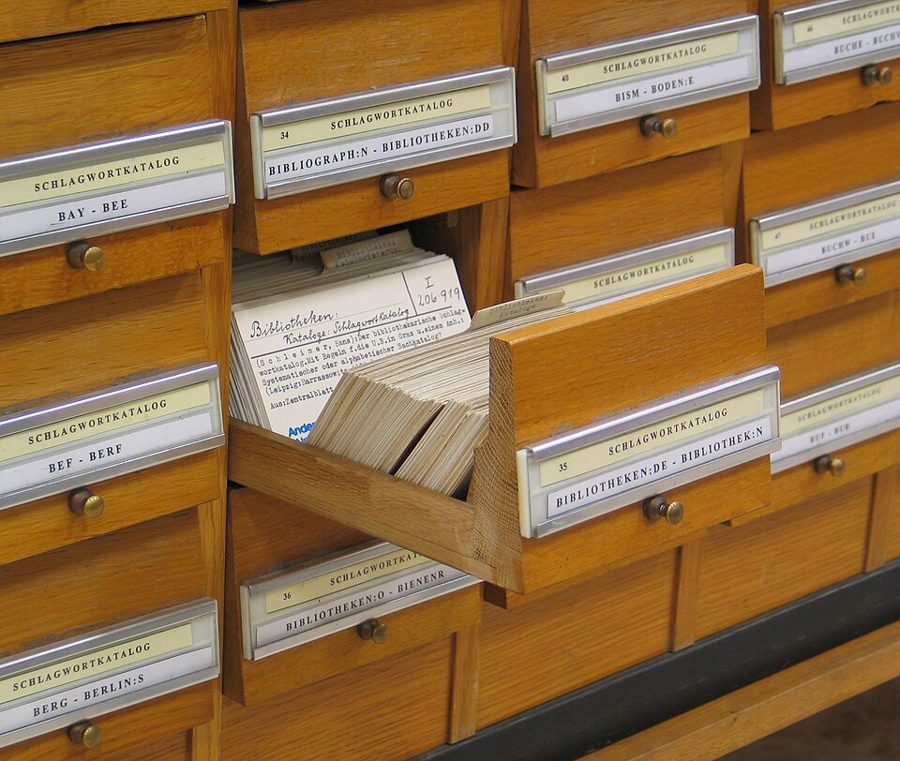
奥地利格拉茨大学图书馆的主题目录:卡片按主题词的字母顺序排在抽屉里。与本书无关,借来做个类比:卡片怎么排,决定了哪些问题查起来便宜;要按另一种方式找,就得再抄一套卡片。这一章比较各种数据模型,比的就是这件事。Marcus Gossler,CC BY-SA 3.0,维基共享资源 读之前:先预测
第 1 章区分了记录系统和派生数据,第 2 章用社交网络的时间线讲了「物化」:预先把查询结果算好,写的时候多干活,读的时候省事。这一章往前退一步,问数据本身该存成什么样子,第 2 章那条时间线会在 §1.2 再出现一次。下一章(第 4 章)讲这些模型在磁盘上怎么实现;第 5 章接着讲模式怎么随时间演化;§3 的事件日志和物化视图,到第 12 章讲流处理时还会接着讲。
一个视频网站给每个用户预先算好「关注动态」,列表里每一条只存视频 ID 和上传者 ID;打开页面时,再按 ID 去查标题、播放量、上传者的昵称和头像,显示最新的 50 条。用户甲关注了 50 个人,用户乙关注了 5000 个人。打开页面时「按 ID 查回内容」这一步,乙的开销大约是甲的多少?
约 100 倍:乙要查的上传者多了 100 倍
差不多:只跟这一页显示多少条有关,每条按 ID 各查一次,还能并行
乙根本查不动,这种设计只能把昵称和头像预先抄进列表里
甲反而更贵:关注的人少,缓存不容易命中
一张 3 亿行的订单表,要把「收货地址」一列拆成「城市」和「详细地址」两列。第一步:加两列,默认值是 NULL;第二步:一条 UPDATE,把旧列拆开填进新列。在大多数关系数据库里,哪一步会跑很久?
两步都很快:数据库只改一下表的定义
第一步慢:加列要把整张表复制一遍;第二步只是填值
两步一样慢:都要碰到每一行
第一步很快,第二步很慢:每一行都要重写
同一份数据可以存成表、文档、图或事件日志。换一种模型,有的查询一句话就写完,有的变得又长又慢。拿到一份数据,该看它的哪些特征来选模型?
一对多、多对一、多对多,哪一种开始让文档模型吃力?关系模型怎么应付它?§1.3
存 ID 和直接存一份文字,各在读和写的哪一边付代价?§1.2
同一个查询,为什么在图查询语言里几行,在 SQL 里要写几十行?§2.3
事件溯源为什么要求事件不可变、而且按固定的顺序处理?§3
这一章的骨架
这一章是一次巡礼:先用很长的篇幅比较关系模型和文档模型(§1),再看图模型和查它的五种语言(§2),最后是两样不太一样的东西:把写和读拆开的事件溯源(§3),以及分析和科学计算里用的数据框与矩阵(§4)。容易乱的是 §2:几种语言轮流查同一个例子,读的时候抓住每一种比前一种多了什么、少了什么,语法不用记。
同一份数据,装成什么形状?
关系长什么样 §1–§2
用什么语言查 §0、§2
读和写要不要分开
一对多(树)→ 文档 §1.1
多对一、多对多 → 关系 §1.3
两派怎么选 §1.5
处处相连 → 图 §2、§2.1
三元组:图的另一种说法 §2.4
声明式:只说要什么 §0
Cypher、SPARQL §2.2 §2.4
SQL 递归查询:很长 §2.3
Datalog:规则推规则 §2.5
GraphQL:故意受限 §2.6
事件日志 → 物化视图 §3
分析:星型和雪花 §1.4
数据框和矩阵 §4
右列都在问:为写入优化的
形状,和为读取优化的形状,
是不是同一个?
贯穿全章:存 ID 还是抄一份 §1.2 · 模式在写入时检查还是读取时解释 §1.5
本站画的全章结构。左列是 §1 的主体,§1.5 是两派的正面比较;中列的几种语言查的是同一个例子,可以对照着读。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
ORM 的账:N+1 查询,每条记录各发一次查询;好处是少写样板代码,能帮着缓存查询结果、管理模式迁移。
存 ID:写法统一、不歧义、改一处就行、好做多语言、好搜索;变得快的数据(点赞数、头像)只存 ID,读时再查。
星型:查询更好写;数仓里是不再修改的历史记录,没有多份副本要同步的问题。
文档模型:不能直接引用文档里的嵌套项,多对一、多对多要靠引用;可拖动排序的列表直接存成数组就行。
GraphQL:不许递归、不许任意搜索条件,因为查询来自不可信的客户端;重复换来的是客户端渲染简单。
事件溯源:外部信息(如汇率)要写进事件或能按时间重查;个人数据难删(GDPR,可用加密粉碎);重放时别重复触发外部副作用。
分节地图
全章约 1.4 万词(不算代码和图注),建议分四次读。第一、二次是关系模型和文档模型的长篇比较;第三次是图,代码多、正文少,读得比词数快;第四次是事件溯源和数据框,彼此独立。
第一次坐下§0–§1.2 · 约 3400 词 · 分层、ORM、存 ID 还是抄一份
Data models are perhaps the most…约 600 词 开篇 数据模型一层叠一层,每层藏住下面的复杂性。方框里讲什么叫声明式查询语言。 Relational Versus Document Models约 400 词 关系模型与文档模型 关系模型的对手来了又走;NoSQL 留下的持久影响之一是文档模型。 The Object-Relational Mismatch约 1000 词 对象与关系的错位 ORM 的毛病和好处、N+1 查询;一对多的数据为什么适合装进一个文档。 Normalization, Denormalization, and Joins约 1400 词 规范化、反规范化与连接 存 ID 还是存文字,两边的代价;回到第 2 章的时间线,看「只存 ID」的折中。 第二次坐下§1.3–§1.5 · 约 2800 词 · 关系的类型、分析用的模式、两派怎么选
Many-to-One and Many-to-Many Relationships约 400 词 多对一与多对多 这两种关系为什么塞不进一个文档;两个方向都要查时靠什么。 Stars and Snowflakes: Schemas for Analytics约 800 词 星型与雪花:分析用的模式 事实表和维度表;数据仓库里的反规范化为什么不成问题。 When to Use Which Model约 1600 词 什么时候用哪种模型 文档模型的长处和局限、读时模式与写时模式、局部性、两派合流。这一块的重心。 第三次坐下§2–§2.6 · 约 4700 词 · 图模型和查它的几种语言
Graph-Like Data Models约 600 词 图状的数据模型 多对多多到什么程度该用图;一张图里可以放完全不同种类的东西。 Property Graphs约 600 词 属性图 顶点和边各由什么组成;用两张关系表也能存下一张图。 The Cypher Query Language约 500 词 Cypher 查询语言 用箭头画出要找的模式;同一个查询可以从哪一头开始执行。 Graph Queries in SQL约 500 词 用 SQL 查图 不知道要走几条边时,SQL 得用递归查询。对比两边的行数。 Triple Stores and SPARQL约 900 词 三元组存储与 SPARQL 主语、谓语、宾语;RDF 为什么用 URI;语义网留下了什么。 Datalog: Recursive Relational Queries约 800 词 Datalog:递归的关系查询 用一条条规则推出新的虚拟表,规则可以调用自己。跟着推导走一遍。 GraphQL约 700 词 GraphQL 查询语言 一种故意受限的语言:给客户端用,不许递归,响应里有重复也认了。 第四次坐下§3–§5 · 约 3100 词 · 事件溯源、数据框,加小结
Event Sourcing and CQRS约 1700 词 事件溯源与 CQRS 写成不可变的事件日志,读从它派生的物化视图;好处一串,麻烦也一串。 DataFrames, Matrices, and Arrays约 800 词 数据框、矩阵和数组 数据科学家怎样一步步把表变成矩阵;独热编码;数组数据库。 Summary约 700 词 小结 全章回顾,外加几种没讲到的模型。先自己回忆一遍再读它。
先用中文过一遍
关系的形状:一对多放进文档,多对多要靠引用
拿一个菜谱 App 来想。一道菜谱有好几个步骤,每个步骤只属于这道菜:这是一对多,整份数据是一棵树。存成一个 JSON 文档最自然,打开菜谱时一次读出全部内容,不用拼。存进关系数据库,就要拆成菜谱表、步骤表,读的时候再按菜谱 ID 拼回来。
再看作者和食材。很多菜谱是同一个作者写的,这是多对一;一道菜用好几种食材,一种食材出现在很多道菜里,这是多对多。把作者的资料、食材的说明抄进每个菜谱文档,改一处就得改一大片,所以文档里只存它们的 ID,指向别的文档。到这一步,文档模型也离不开「按 ID 去找另一条记录」,也就是连接。关系模型处理多对多的标准做法,是一张关联表:每一行把一个菜谱 ID 和一个食材 ID 连起来,两列各建一个索引,两个方向都能查。
文档:一对多嵌在里面
菜谱 #8812(一个文档)
标题:番茄炒蛋
步骤:[切块, 打散, 翻炒]
用量:[{食材 #5, 2 个},
{食材 #9, 3 个}]
作者:#31
食材 #5 番茄
食材 #9 鸡蛋
作者 #31
步骤只属于这道菜(一对多):直接嵌进来
作者(多对一)、食材(多对多):只存 ID,
指向别的文档,读的时候再去查
关系:拆成几张表
菜谱(id, 标题, 作者_id)
步骤(菜谱_id, 序号, 内容)
用量(菜谱_id, 食材_id, 数量)
食材(id, 名称)
作者(id, 昵称)
用量是关联表:一行连一个菜谱和一个食材,
两列各建索引,两个方向都能查
读一整道菜谱:要查好几张表,或做多路连接
本站画的示意图,菜谱和 ID 是编的。左边读一道菜谱只要取一个文档,右边要拼好几张表;反过来,「哪些菜用了番茄」在右边查一张有索引的表就行,在左边要给文档里数组中的 ID 另建索引才快。
存 ID 还是抄一份:规范化和反规范化
公司内部的工单系统,每张工单要显示负责人的名字。可以只存员工 ID,显示时再按 ID 查名字;也可以把名字直接抄进工单里。前一种叫规范化:给人看的信息只存一处,别处都用一个对人没有意义、所以永远不用改的 ID 去引用。员工改了显示名,改一行就完了,代价是每次读工单都要多查一次(关系数据库里是连接,在应用代码里按 ID 查回来叫「补全」)。后一种叫反规范化:读的时候直接拿到,但改名要改所有副本,漏改一张,数据就前后不一了。
这和第 2 章的物化是一回事:反规范化的副本是派生数据,你得有一套机制在原数据变了以后去更新它们。书里还讲了一种折中:预先算好的列表里只存 ID,读的时候再补全。哪些东西抄、哪些只存 ID,要看它变得多快、读写各有多贵。
存 ID(规范化)
工单 1:负责人 31,卡纸
工单 2:负责人 31,VPN 断线
工单 3:负责人 31,换显示器
31:小周
改名:改 1 行
读工单:每张都要按 ID 再查一次
(数据库里做连接,或在应用里补全)
抄一份(反规范化)
工单 1:31,小周 ,卡纸
工单 2:31,小周 ,VPN 断线
工单 3:31,小周 ,换显示器
读工单:直接拿到,不用再查
改名:改 N 张,漏一张就不一致
(副本是派生数据,要有机制去更新)
折中:预先算好的列表只存 ID,读的时候再补全;变得快的东西不抄(§1.2)
本站画的示意图。规范化把代价放在读上,反规范化把代价放在写上,还多占空间。两边哪个更划算,书里给了几条判断的依据。
图:顶点、边,和不知道要走几步的查询
多对多的关系一多,而且各种东西互相连着,用图更自然:每样东西是一个顶点,每个关系是一条边。属性图模型里,顶点和边都带一个标签(「这是文件夹」「这是编辑过」)和一组键值属性。任何顶点都能连向任何顶点,一张图里可以同时放人、文件、文件夹、标签。
图查询难在路径的长度事先不知道。拿网盘来说:「小周编辑过的文件里,哪些在共享盘『项目资料』下面?」文件可能直接在共享盘里,也可能隔了三层子文件夹。图查询语言可以写「沿着『在……里面』的边走一次或多次」;关系数据库的每走一条边就是一次连接,连接的次数不固定,就得用递归查询(WITH RECURSIVE):从根开始一轮轮往下展开,直到没有新的为止。
问:小周编辑过的文件里,
哪些在「项目资料」下面?
实线箭头:在……里面
虚线箭头:编辑过
从根往下一轮轮展开:
第 1 轮:设计稿、合同
第 2 轮:初稿、logo、报价单
第 3 轮:封面
第 4 轮:没有新的,停
共享盘「项目资料」
文件夹:设计稿
文件夹:合同
文件夹:初稿
logo.png
报价单.xlsx
封面.psd
用户:小周
要走几层事先不知道:这就是递归查询要做的事。答案:logo.png、封面.psd
本站画的示意图,网盘里的文件夹和文件是编的。图数据库从「项目资料」出发反着走边;关系数据库把顶点和边各存一张表,每走一层就是一次连接。
用属性图的查询语言(这里按 Cypher 的写法)大概是这样,*1.. 的意思是这条边走一次或多次:
MATCH (u:User {name: '小周'}) -[:EDITED]-> (f:File)
      -[:IN*1..]-> (:Folder {name: '项目资料'})
RETURN f.name
同一件事,顶点存在 items 表、边存在 links 表,用 SQL 的递归查询写:
WITH RECURSIVE under(id) AS (
    SELECT id FROM items WHERE kind = 'folder' AND name = '项目资料'
  UNION
    SELECT l.src FROM links l JOIN under ON l.dst = under.id
    WHERE l.kind = 'in'
)
SELECT f.name
FROM items f
JOIN under ON f.id = under.id
JOIN links e ON e.dst = f.id AND e.kind = 'edited'
JOIN items u ON u.id = e.src AND u.name = '小周'
WHERE f.kind = 'file';
这两段是本站写的。书里用另一个例子,把同一个查询分别用 Cypher、SQL、SPARQL、Datalog 写了一遍,读的时候留意行数差多少,以及 Datalog 怎么把递归拆成两条规则。
事件溯源:先记下发生了什么,读的样子另外算
前面几种模型,写进去的形状就是读出来的形状。事件溯源把两者拆开:写的时候只往一个日志末尾追加事件,每个事件用过去时说一件已经发生的事(「书已借出」「书已归还」),写进去就不再改、不再删;读的时候不查日志,而是查从日志派生出来的物化视图,每个视图为一类查询优化。这种「写一种表示、读另几种表示」的做法叫 CQRS。
用户的请求先是一个「命令」,校验通过了才变成事件写进日志,所以日志里只有有效的事件,下游的视图不能拒收。视图随时可以删掉,按同样的顺序、用同样的代码把事件重放一遍,就能重新算出来;这要求处理事件的逻辑是确定的,重放时也不能重复做发短信这类对外的动作。
命令:借书 207
校验:在架上吗?
读者欠费了吗?
通过才变成事件;
不通过就拒绝,
日志里不留
事件日志(只追加)
#1 书 207 已上架
#2 书 207 已被读者 18 借走
#3 读者 18 已续借书 207
#4 书 207 已归还
#5 新事件追加在这里
事件用过去时,写进去就不改不删
视图:每本书现在在哪
视图:每位读者在借的书
视图:逾期催还名单
视图可以删掉,按同样的顺序
重放全部事件,重新算出来
重放时别再发一遍催还短信
写为追加优化,读为各自的查询优化:两边的形状不必相同
本站画的示意图,图书馆和编号是编的。还书这件事不会把「已借出」那条事件改掉,而是追加一条新事件;「在借的书」这个视图读到它,才把书从列表里拿掉。
这一章点名的系统
MongoDB 文档数据库 把文档模型带火的数据库之一;它的聚合管道是一种用 JSON 语法写的查询语言,也能用 $lookup 做连接。
Spanner 关系数据库 书里拿它说明关系模型也能有局部性:子表的行可以声明成交错存放在父表的行里。
Neo4j 图数据库 属性图模型;Cypher 最早就是为它设计的,后来成了开放标准 openCypher。
Amazon Neptune 图数据库 同时支持属性图和三元组两种模型;三元组外加一个图 ID,存成四元组。
Datomic 数据库 用 Datalog 查询;每条记录是五元组:三元组加上事务 ID 和一个表示删除的标记。
EventStoreDB 事件存储 书里列的几个专为事件溯源设计的系统之一。
Pandas Python 库 支持数据框模型的代表之一,数据科学家用它一步步整理数据。
TileDB 数组数据库 专门存大型多维数值数组,常用在地理测量、医学影像、天文观测这类科学数据上。
TigerBeetle 账本数据库 小结里的例子:专做复式记账账本这一种数据模型。
英文 中文 一句话 declarative query language 声明式查询语言 只说要什么样的结果,不说怎么算;用哪个索引、按什么顺序连接,由数据库的查询优化器定(§0)。 impedance mismatch 阻抗失配 应用里的对象和数据库里的表、行、列对不上,中间要一层翻译。借自电子学(§1.1)。 ORM 对象关系映射 自动做这层翻译的框架,比如 ActiveRecord、Hibernate(§1.1)。 N+1 query problem N+1 查询问题 先查出 N 条记录,再为每一条各查一次关联的数据,一共 N+1 次(§1.1)。 normalization 规范化 给人看的信息只存一处,别处用 ID 引用;抄到每条记录里叫反规范化(§1.2)。 join / hydrating 连接 / 补全 按 ID 把两处的数据拼起来;在应用代码里按 ID 把内容查回来,书里叫补全(§1.2)。 many-to-many 多对多 两边都可以对应多个;关系模型里用一张关联表(join table)来存(§1.3)。 star schema 星型模式 中间一张事实表,一行一个事件,四周是维度表;维度再拆细就是雪花模式(§1.4)。 schema-on-read 读时模式 数据库不检查结构,读数据的代码自己假定一种结构;相对的是写时模式(§1.5)。 property graph 属性图 顶点和边都带一个标签和一组键值属性(§2.1)。 recursive common table expression 递归公用表表达式 SQL 的 WITH RECURSIVE,用来走长度不固定的路径(§2.3)。 triple store 三元组存储 所有信息都写成(主语,谓语,宾语)三段式(§2.4)。 event sourcing / CQRS 事件溯源 / 命令查询职责分离每次状态变化记成一条不可变的事件;读用从事件派生的另几种表示(§3)。 materialized view 物化视图 预先算好、存下来的查询结果;在事件溯源里也叫投影、读模型(§3)。 DataFrame 数据框 像一张表,但用一串命令一步步改;常用来把数据变成矩阵(§4)。
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(normalization、schema-on-read 这类)不在这里,在上面的术语表里。
§0 Data models are perhaps the most…
in terms of
… represented in terms of the next-lower layer. …
用(下一层的东西)来表达
不是常见的「就……而言」。represent A in terms of B 是「用 B 来表示 A」,这一章反复出现。
awkward
… one model and awkward in another. …
(表达起来)别扭、费劲
§1 Relational Versus Document Models
tool of choice
… had become the tools of choice …
首选的工具
of choice 放在名词后面,是「大家都挑它」的意思。
come and go
… came and went again in the late …
兴起又消失
came and went 说一样东西热过一阵就没了,带一点「昙花一现」的味道。
niche adoption
… have seen only niche adoption. …
只在小圈子里用
hype
… generated a lot of hype …
炒作、热捧
buzzword
… was the latest buzzword that tried …
时髦词
brand oneself as
… Some databases branded themselves as NewSQL, …
给自己打上……的招牌
brand 当动词,是营销上的自称,不一定名副其实。
§1.1 The Object-Relational Mismatch
disconnect (n.)
… The disconnect between the models is …
脱节、对不上
名词用法,不是「断开连接」这个动作。
boilerplate code
… reduce the amount of boilerplate code …
样板代码
指每次都得照着写一遍、没什么新意的那部分代码,和「样板间」的样板意思不同。
end up having to
… developers still end up having to …
到头来还是得
本想省掉的事,最后没省掉。
in the first place
… using the ORM in the first place.
当初、原本(用它的理由)
不是「第一,首先」。negate the benefit of … in the first place:把当初选它的好处抵消了。
lend itself well to
… Not all data lends itself well …
很适合(用某种方式处理)
messy
… perform a messy multiway join …
乱糟糟的、不干净的
unwieldy
… may be too unwieldy, …
太笨重、不好摆弄
§1.2 Normalization, Denormalization, and Joins
across the board
… easy to update across the board …
所有地方一律
across 不是「穿过」:改一处,所有引用它的地方都跟着变。
create a headache
… it creates a headache if we …
惹出麻烦
fare better
… analytical systems often fare better with …
表现更好、更合适
fare 在这里是动词「过得、进展」,和「车费」那个名词 fare 不是一个意思。
as sometimes claimed
… is not, as sometimes claimed, an …
(并不像)有人说的那样
作者在反驳一种流行的说法:读时做连接,并不妨碍做出高性能、可扩展的服务。
dominated by outliers
… might be dominated by outliers, …
主要由极端情况决定
not inherently good or bad
… are not inherently good or bad—they …
本身无所谓好坏
§1.4 Stars and Snowflakes: Schemas for Analytics
so-called
… is a so-called fact table …
叫作……的
技术写作里常是中性的,只是引出一个术语,不带中文「所谓」的贬义。
just happen to
… all just happen to have the …
只是恰好
口吻上强调「没有明确的联系」:几行属于同一笔交易,表里看不出来,只是客户、门店、时间碰巧相同。
fold into
… folding the information in the dimensions …
并入
fold 本义折叠,这里是把维度表的内容揉进事实表里。
pressing
… are not as pressing in analytics.
紧迫的
形容词,不是「按压」。
§1.5 When to Use Which Model
counter (v.)
… The relational model counters by providing …
反驳、回敬
辩论里的「还击」。这里把两种模型写成在辩论。
cumbersome
… can lead to cumbersome schemas …
笨重繁琐的
no clear winner
… there’s no clear winner.
分不出明显的赢家
contentious
… is a contentious topic, …
有争议的
operationally challenging
… on large databases remains operationally challenging.
运维上依然很难
challenging 是往轻里说的「有挑战」,实际意思是很难、容易出事。
practicable
… it is not practicable to put …
行得通的、可以实施的
和 practical(实用的)不是一个词。not practicable:根本做不到或代价大到没法做。
get a feel for
… to get a feel for this language …
找找感觉、大致体会一下
a matter of taste
… is perhaps a matter of taste.
口味问题、看个人喜好
§2.1 Property Graphs
intricacies
… ignoring for now the intricacies of …
错综复杂的细节
§2.2 The Cypher Query Language
work backward
… Location vertices and work backward. …
倒着推、从结果那头往回找
§2.3 Graph Queries in SQL
with some difficulty
… is yes, but with some difficulty.
(能,)但不太容易
往轻里说。看看后面那段 31 行的 SQL,就知道 some 有多少。
clumsy
… very clumsy in comparison to Cypher.
笨拙
§2.4 Triple Stores and SPARQL
additions to your toolbox
… valuable additions to your toolbox …
工具箱里多出的好用的东西
legacy lives on
… the project’s legacy lives on in, …
(项目没成,)留下的东西还在用
legacy 在这里是「遗产」,不是代码里的「遗留、过时」。
quirk
… RDF has a few quirks because …
怪异之处、与众不同的地方
不等于缺陷。后文说这些怪处有它的理由。
resolve to
… need to resolve to anything—from …
(网址)能解析、指向某个真实的东西
不是「决心」。这里说这个 URL 打开不一定有网页,只当命名空间用。
§2.5 Datalog: Recursive Relational Queries
ought to be better known
… but it ought to be better known …
本该更有名
作者明确表态,替它叫屈。
put someone off
… don’t let that put you off. …
让人打退堂鼓
不是「推迟」。别因为它长得怪就不想看了。
jump in right away
… jump in right away with SELECT, …
上来就直奔主题
§2.6 GraphQL
by design
… that, by design, is much more restrictive …
有意这样设计的
强调受限是故意的,不是没做完。
come at a cost
… That flexibility comes at a cost, …
是有代价的
§3 Event Sourcing and CQRS
be it
… be it JSON documents, rows …
无论是……
古一点的虚拟语气,等于 whether it is。
supersede
… which may supersede earlier events) …
取代(更早的)
communicate the intent
… events better communicate the intent of …
表达出意图
communicate 在这里是「传达、让人看懂」,不是「交流」。
chain off
… chain new behaviors off existing events …
接在(已有事件)后面挂上新的动作
at their own pace
… catch up at their own pace …
按自己的节奏
you probably don’t want to
… you probably don’t want to resend …
你肯定不想……
往轻里说的警告,意思是「千万别」。
§4 DataFrames, Matrices, and Arrays
feature (v.)
… rarely feature in OLTP systems, …
出现、占一席之地
feature 当动词,「在……里出现」。
wrangle
… incrementally “wrangle” the data into …
(费劲地)整理、摆弄数据
本义是争吵、驱赶牲口。data wrangling 是数据科学里的常用说法,加引号表示借用。
amenable to
… it is amenable to linear algebra …
适合做(某种处理)
§5 Summary
whet your appetite
… whet your appetite to find out …
勾起你的兴趣
whet 是磨刀,「把胃口磨尖」。
ubiquitous
… SQL queries are ubiquitous. …
随处可见的
cover a lot of ground
… we have covered a lot of ground, …
讲了很多内容
ground 是「地面、领域」,不是「基础」。
leave it there
… We have to leave it there …
先说到这里
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
书里的答案是第二项(§1.2)。列表是预先算好的,打开页面时只需要把这一页的 50 条按 ID 查回来:每条一次查询,彼此独立,可以并行。开销取决于一页显示几条,和你关注了多少人、有多少人关注你都无关。书里拿 X 的时间线说明的正是这一点:读时做连接,并不一定妨碍扩展。只存 ID 的原因也在这一节:点赞数、昵称、头像变得太快,抄进列表要么过时,要么得不停地改写成千上万份副本。想一想:如果不预先算好列表,每次打开页面都现场去查所有关注对象的最新视频,答案会变吗?
书里的答案是第四项(§1.5)。在大多数关系数据库里,加一个带默认值的列很快,大表也一样;慢的是 UPDATE,因为每一行都要重写。书里还给了一个绕开的办法:只加一个默认为 NULL 的列,旧数据等到读的时候再拆,这其实就是文档数据库读时模式的做法,代价是每个读这张表的地方都要处理新旧两种格式。想一想:如果要改的是某一列的数据类型,答案会变吗?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
这份数据存成什么样最省事?§1.5
场景:一个低代码表单平台,每个客户自己定义表单的字段,几千种表单各不相同,客户还会随时加减字段。提交上来的数据几乎总是整份展示、整份导出。
每种表单建一张表,客户改字段就改表 每份提交存成一个 JSON 文档(或关系库里的 JSON 列),读的时候按表单定义去解释 用图数据库,每个字段做成一个顶点 所有表单共用一张宽表,预留 200 个通用列
这正是书里说的读时模式占优的情形:对象种类多到没法每种一张表,结构由外部(客户)决定、随时会变。整份读写还能享受文档的局部性。每种一张表要不停地做模式迁移;图模型擅长的是错综的关系,这里没有;预留通用列看着是一张表,其实每列的意思还是要在读的时候按表单去解释,还白白浪费列。
两个方向都要查的共享关系,怎么存?§1.3
场景:网盘里一个文件夹可以共享给很多人,一个人也能收到很多人的共享。「我共享出去的」和「共享给我的」两个页面都要快。现在的设计是在文件夹文档里存一个「共享对象 ID」数组。
在用户文档里也存一份「共享给我的文件夹 ID」数组,两边一起写 打开「共享给我的」时,扫一遍所有文件夹文档 把收到的共享连同文件夹的全部内容,嵌进收件人的用户文档 关系只存一处,在两个查询方向上各建一个索引(文档数据库可以给数组里的值建索引)
多对多关系要双向查,书里的规范化做法是关系只存一处,靠二级索引支持两个方向:关系表的两列各建索引,或者在文档数组里的 ID 上建索引。两边各存一份是反规范化,一边写成功、一边失败,两份就对不上了。全表扫描太慢;把文件夹内容嵌进收件人文档,文件一改就要改所有副本。
层数不固定的物料清单,怎么查?§2.3 §2.6
场景:一家设备厂的物料清单:整机由部件组成,部件又由更小的部件组成,层数不固定。数据在 PostgreSQL 里,一张「父部件—子部件—数量」的表。新需求:列出某个型号的整机用到的全部螺丝,不管在第几层。
用 WITH RECURSIVE 写一个递归查询,让数据库一层层展开,直到没有新的部件 写一条 SQL,把这张表连接 6 次,假设不会超过 6 层 在 GraphQL 里写一个嵌套查询,让它自己递归展开 在应用里写循环:每查到一层,再对这一层的每个部件各发一次查询
要走的边数事先不知道,正是书里说的递归公用表表达式的用处:写起来比图查询语言啰嗦,但能在数据库里一次做完。写死 6 次连接,哪天多一层就悄悄漏掉螺丝;GraphQL 故意不支持递归查询;应用里一层层发查询能得到对的结果,但请求次数随部件数增长,是 N+1 问题的放大版。
重建视图之后,历史报表的数字为什么变了?§3
场景:一家连锁咖啡店的会员系统用事件溯源,「订单已支付」事件里只记了消费金额。积分视图处理事件时,去配置服务读当前的「每消费 1 美元积几分」。上个月运营把这个比例从 10 调成了 12。前几天修了积分视图的一个 bug,删掉视图、从头重放事件,结果所有老会员的历史积分都变多了。
有人改过日志里的历史事件 重放时事件的顺序乱了 视图在处理事件时去外部读当前的积分比例,重放时读到的已经是新比例 重放时漏掉了退款事件
书里讲过同一类问题:视图要能从日志可重复地算出来,处理逻辑就必须是确定的。积分比例是事件之外的信息,今天读和去年读不一样。办法是把当时的比例写进事件,或者按事件里的时间戳去查当时生效的比例,保证同一个时间戳永远得到同一个结果。事件不可变,顺序由日志保证;漏掉退款事件只会让个别会员的积分偏多,而且漏的是本该有的扣减,不会让所有人都按同一个比例变多。
分析师嫌查询难写,数仓的模式怎么改?§1.4
场景:一家连锁健身房的数据仓库,事实表一行是一次上课签到。维度又拆成了子维度:门店→城市→大区,课程→课程类别,教练→教练等级。分析师抱怨一条查询要连接七八张表。
再拆细一点,让每张维度表更规范 把事实表改成每个会员一行的汇总表 把子维度并回维度表,改成星型;查询特别频繁的,甚至把维度也折进事实表 换成图数据库,用路径查询代替连接
现在是雪花模式。书里说星型虽然没那么规范化,但分析师用起来更简单,所以常被优先选择;再往前一步是一张大表,相当于把连接预先算好,多占空间、换更快的查询。数仓里的数据是不再修改的历史记录,反规范化带来的一致性问题在这里不突出。改成每个会员一行的汇总,就丢了「事实按单个事件记录」带来的分析灵活性;图数据库对这种多对一为主的结构没有帮助。
和本站其他书对照
不同的层,不同的抽象 APOSD 第 7 章 这一章开头说,应用是一层数据模型叠在另一层上,每一层用一个干净的模型把下面的复杂性藏起来。APOSD 第 7 章把这当成判断分层好坏的标准:沿着一次操作往下走,每过一层,抽象就该换一次;相邻两层说的是同一套话,这一层就没挣回它的成本。
去那一页 → 漏掉了重要细节的抽象 APOSD 第 4 章 APOSD 说,抽象多放了不重要的细节会变重,漏掉了重要的细节就成了虚假的抽象。本站的看法:§1.1 的 N+1 查询是个现成的例子,ORM 把「这一页要发几次查询」藏了起来,而这恰恰是决定页面快慢的细节。
去那一页 →
值得停下来的句子
Document databases are sometimes called schemaless, but that’s misleading as the code that reads the data usually assumes some kind of structure— §1.5。本站译:文档数据库有时被称为「无模式」的,但这个说法有误导性:读数据的代码通常都假定了某种结构。
值得停,是因为它把一场常见的争论换了个问法。问题从来不是「要不要模式」,而是模式写在哪里、由谁来保证:写时模式由数据库在写入时把关,读时模式散落在每一段读数据的代码里。书里拿它类比静态类型和动态类型,两边各有拥护者。读到第 5 章的模式演化时,这句话还会派上用场。
You should always be able to delete the materialized views and recompute them by processing the same events in the same order…— §3。本站译:你应该随时可以删掉物化视图,按同样的顺序处理同样的事件,把它们重新算出来……
事件溯源的好处,几乎都从这一条长出来:视图有 bug 就删掉重算,想换个方式展示就再派生一个视图。它的麻烦也都是为了守住这一条:处理逻辑必须确定(不能现取汇率),日志的顺序必须固定,重放时不能再触发对外的动作。第 12 章讲流处理时,会回到事件日志和物化视图这个话题。
检查一下理解
1.(§0)声明式查询语言的好处,为什么不只是「写起来短」? 它把执行细节交给了数据库:用哪个索引、按什么顺序连接、要不要并行,都由查询优化器决定。所以数据库改进了执行方式,查询一个字都不用改。
2.(§1.1)N+1 查询问题是怎么出现的?怎么避免? 用 ORM 先查出 N 条记录,再为每一条各发一次查询去取关联数据,一共 N+1 次,比在数据库里做一次连接慢。办法是告诉 ORM 在取主记录时一并取回关联数据。
3.(§1.2)为什么说用 ID 引用时,ID 本身永远不用改? ID 对人没有意义,只在数据库内部用。它指向的信息(地名、公司名)可以变,ID 不必跟着变;而对人有意义的东西迟早可能要改,抄了多份就得每份都改。
4.(§1.4)星型模式里,事实表的一行代表什么?维度表回答哪些问题? 一行是某个时刻发生的一个事件,比如一次购买。维度表通过外键挂在事实表上,回答这个事件的谁、什么、在哪、何时、怎样、为什么。日期也常做成维度表,好标出节假日。
5.(§1.5)文档模型适合什么样的数据?它有什么局限? 适合一对多的树、通常整棵一起读的数据。局限是不能直接引用文档里的嵌套项,多对一、多对多要靠引用;文档要整个读、整个重写,所以最好小一点,避免频繁的小更新。
6.(§2.1)图模型里一条边只能连两个顶点。要表示三方的关系怎么办? 为每一个这样的关系建一个额外的顶点,再从它连边到三方各自的顶点;或者用超图。关系表做这件事更直接:一行里放三个外键就行。
7.(§2.6)GraphQL 为什么故意不支持递归查询和任意搜索条件? 它的查询来自用户设备上的客户端,是不可信的来源。允许执行代价很高的查询,用户(哪怕无意)就可能把服务器拖垮,造成拒绝服务。
8.(§3)事件溯源里,命令和事件有什么区别?事件为什么用过去时命名? 命令是用户发来的请求,要先校验,可能被拒绝;校验通过、执行了,才变成事件写进日志,此后就是既成事实,下游不能拒收。过去时表明它记录的是已经发生的事,以后取消也只是追加一个新事件。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 选数据模型,先看数据之间的关系长什么样:树用文档,多对多靠引用和连接,四通八达用图;写和读的形状不同,就把它们拆开。
「无模式」其实有模式 文档数据库不检查结构,但读数据的代码一定假定了结构。区别只在模式写在哪儿:写入时由数据库把关,还是读取时由代码解释。
§1.5 关注一万人也不怕补全 预先算好的列表只存 ID,读时按 ID 查回内容。这一步的开销只和一页显示几条有关,还能并行。
§1.2 四行对三十一行 同一个「沿着边走任意多步」的查询,书里的 Cypher 写了 4 行,SQL 的递归查询写了 31 行。模型和语言选得对不对,差别就这么大。
§2.3 事件用过去时 事件记的是已经发生的事,写下就不改;后来取消了,也只是再追加一条。视图随时可以删掉,重放日志再算一遍。
§3 GraphQL 故意不让你递归 查询来自不可信的客户端,所以不许递归、不许任意条件搜索。名字里有 graph,底下可以是任何数据库。
§2.6 拖来拖去的待办列表 用户自己排顺序的列表,文档里存成一个数组就完事;关系数据库没有标准做法,只能靠整数排序列、链表或分数索引这类技巧。
§1.5 Codd 早就允许嵌套 关系模型最初的描述里,一个值可以是一张嵌套的表。三十多年后 SQL 加上 JSON 和 XML,算是绕回来了。
§1.5