这一章在做什么
一个应用除了「要做什么」,还有一串很少写下来的要求:要快、要稳、扛得住增长、改得动。这一章把其中四项说成能测、能讨论的东西。开头用一个推送新内容的案例算账:结果是读的时候现算,还是写的时候先算好存起来。接着讲性能怎么描述(响应时间是一个分布,要看百分位和尾巴)、可靠性(一个部件出错不等于整个系统停摆)、可扩展性(先把负载说清楚)和可维护性。每一项都有代价,要拿数字去权衡。
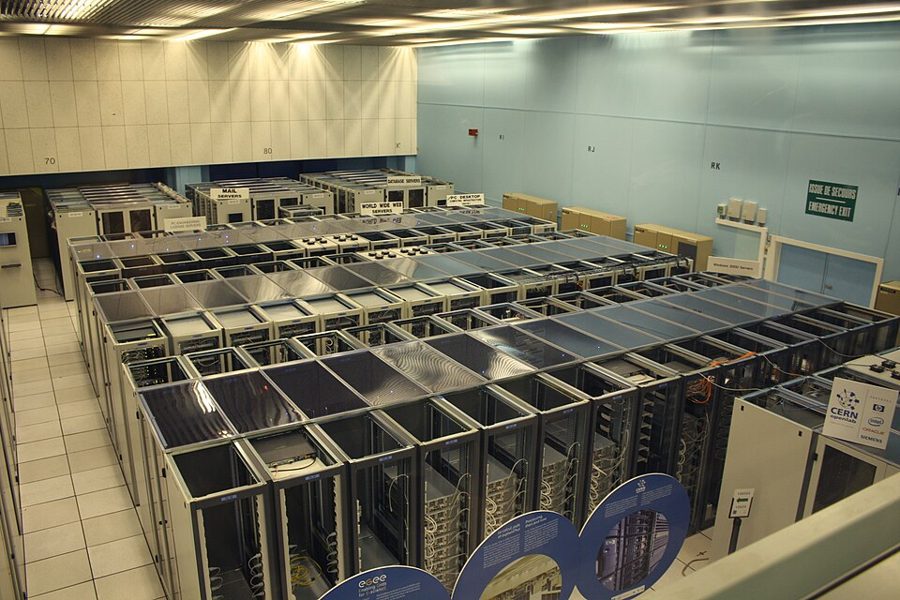
CERN 的数据中心机房,照片说明里说这里放着万维网和邮件的服务器。机器一多,坏盘、死机就不再是意外,而是每天的日常(§3.2 有一组硬件故障率),可靠性得靠系统设计来兜。照片与本书无关。Hugovanmeijeren,CC BY-SA 3.0,维基共享资源 读之前:先预测
第 1 章讲架构上的几对取舍:事务型和分析型、云服务和自建、分布式和单机。这一章给全书准备一套说话的词:响应时间、百分位、故障与失效、负载、可扩展。后面处处用到它们:第 6 章的复制和第 7 章的分片,分别回答「坏了怎么办」和「装不下、扛不住怎么办」;第 9 章细讲这一章一笔带过的超时和不可预测的延迟;第 12 章回到这里提到的「恰好一次」。
一次搜索要并行查 100 个分片,等全部返回才出结果。每个分片 99% 的调用在 50 毫秒内返回,1% 要 1 秒以上,各分片之间互不影响。大约多大比例的搜索要等 1 秒以上?
约 1%:每个分片都只有 1% 慢,整体也差不多
约 10%:慢的会多一些,但大部分还是快的
约 63%:只要碰上一个慢分片就慢,100 个里至少碰上一个的机会很大
约 50%:快慢各占一半
几乎 100%:100 个分片里总会有一个慢
两台机器在负载均衡后面平分流量。监控看板上,一台的 p99 是 100 毫秒,另一台是 900 毫秒。整个服务的 p99 是多少?
500 毫秒:两台流量一样,取平均
900 毫秒:取慢的那一台
1000 毫秒:两台加起来
光凭这两个数算不出来,要把两台的响应时间分布合起来再算
「要快」「要稳」「以后用户多了也得扛住」「要好改」,人人都这么要求。怎样把这些话说成能测量、能拿来做取舍的需求?说清楚之后,各自的代价落在哪里?
把查询结果预先算好存起来,省的是哪边的活、多出来的是哪边的活?碰上极端的用户怎么办?§1.2
为什么不看平均响应时间,而要看 p99、p999?一个请求要调很多后端时,尾巴为什么变重?§2.2 §2.3
故障和失效差在哪?为什么软件故障常常比硬件故障更难对付?§3 §3.2
说「X 可扩展」为什么没意义?讨论扩展时该问什么?§4
这一章的骨架
这一章先讲一个案例(§1),然后四项需求各占一节:性能(§2)、可靠性(§3)、可扩展性(§4)、可维护性(§5)。案例里的数字在性能和扩展两节被反复拿来举例,读后面时可以翻回去对。容易乱的是 §2 和 §3:§2 里响应时间、延迟、服务时间三个词有各自的意思;§3 开头那对 fault 和 failure,后面整节都靠它。
非功能需求:除了「做什么」之外
开场案例 §1:一页内容,读的时候现拼,还是写的时候先推好?
性能 §2
可靠性 §3
可扩展性 §4
可维护性 §5
吞吐和响应时间 排队、过载 §2
响应时间拆开看 §2.1
看分布:百分位 §2.2
尾巴放大、SLO §2.3
故障 ≠ 失效 §3
容错、故意制造故障 §3.1
硬件和软件故障 §3.2
人和组织 §3.3
先把负载说清楚 §4、§4.1
往上扩还是往外扩 三种架构 §4.2
没有万能的架构 §4.3
让运维省心 §5.1
管住复杂度 §5.2
以后改得动 §5.3
每一项都要落到能测的数字上,才谈得上取舍
虚线:案例里的数字在这两列反复出现
本站画的全章结构。四列彼此独立,可以分开读;§2 和 §4 都会回头引用开场案例。
边读边填:每行一个问题,读到答案就写一两句。只存在你这台设备的浏览器里,别人看不到。
读完了?对照我找到的
扇出的代价:每发一条都要写进每个粉丝的时间线;关注太多的人可以丢掉一部分写入,粉丝极多的名人单独存,读的时候再并进来。
过载:请求要排队等前面的处理完;超时重试让请求更多,形成重试风暴,负载降下来了系统也可能卡在过载状态(亚稳态失效)。
在哪里量:排队时间不算在服务时间里,几个慢请求堵在前面,后面快的请求在客户端看来也慢。
百分位怎么合:取平均在数学上没有意义;要把各台的直方图加起来再算。
冗余的前提:各部件的故障彼此独立;同一份软件里的同一个 bug 会在所有节点上同时发作。
人为失误:它是社会技术系统出了问题的症状;做法是无责复盘、测试、快速回滚、逐步发布、好的监控和界面。
规划多远:一般不超过一个数量级;把系统拆成能独立运行的小部件,以及不要比需要的更复杂。
分节地图
全章约 9100 词(不算代码和图注),建议分三次读,每次一个主题:第一次是案例和性能,第二次是可靠性,第三次是可扩展性和可维护性。第二次的 §3.2 最长,大半是一条条故障的例子,可以读得快些。
第一次坐下§0–§2.3 · 约 3300 词 · 一个案例,然后是怎么描述性能
If you are building an application…约 300 词 开篇 功能需求和非功能需求的区别;这一章挑了哪四项来讲。 Case Study: Social Network Home Timelines约 100 词 案例:社交网络的首页时间线 案例的设定:每天发多少条、平均关注多少人。后面的计算都从这几个数出发。 Representing Users, Posts, and Follows约 300 词 怎么表示用户、帖子和关注 最直接的做法是读的时候现查现拼。算一算它每秒要做多少次查找。 Materializing and Updating Timelines约 600 词 把时间线物化并保持更新 反过来,写的时候先推好。工作量挪到了哪里,两种极端用户怎么处理。 Describing Performance约 500 词 描述性能 吞吐和响应时间,以及两者为什么相互牵连。方框里讲过载后回不来的系统。 Latency and Response Time约 400 词 延迟和响应时间 几个容易混用的词在本书里各指什么;响应时间为什么时快时慢。 Average, Median, and Percentiles约 700 词 平均值、中位数和百分位数 为什么看分布不看平均;高百分位对谁要紧。方框里是几份常被引用的研究,留意作者的保留。 Use of Response Time Metrics约 400 词 响应时间指标怎么用 一次请求调很多后端时尾巴怎么放大;SLO 和 SLA;方框讲百分位怎么算、怎么合。 第二次坐下§3–§3.3 · 约 2600 词 · 可靠性:部件会坏,系统要撑住
Reliability and Fault Tolerance约 300 词 可靠性和容错 「可靠」的几条直观期待;故障和失效这对词怎么分。 Fault Tolerance约 400 词 容错 容错总有范围;为什么有人故意制造故障。 Hardware and Software Faults约 1100 词 硬件故障和软件故障 一组硬件故障率,冗余能做什么;软件故障为什么更难缠。全章最长的一节。 Humans and Reliability约 800 词 人和可靠性 怎么看待人为失误,组织该做什么。方框讲可靠性对普通应用有多要紧。 第三次坐下§4–§6 · 约 3200 词 · 可扩展性和可维护性,加小结
Scalability约 300 词 可扩展性 什么时候该操心扩展,什么时候不该;讨论扩展该问哪几个问题。 Understanding Load约 400 词 理解负载 用什么数描述负载;负载涨了,从哪两个角度看系统的反应。 Shared-Memory, Shared-Disk, and Shared-Nothing Architectures约 400 词 共享内存、共享磁盘和无共享架构 加资源的三种办法,各自卡在哪里。 Principles for Scalability约 300 词 可扩展的原则 为什么没有通用的可扩展架构;两条普遍适用的原则。 Maintainability约 300 词 可维护性 软件的钱大多花在上线以后;可维护性拆成三个方面。 Operability: Making Life Easy for Operations约 300 词 可运维性:让运维省心 自动化的两面;数据系统能替运维做哪些事。 Simplicity: Managing Complexity约 500 词 简单:管住复杂度 「简单」为什么难有客观标准;抽象是对付复杂度的主要工具。 Evolvability: Making Change Easy约 300 词 可演化性:让改动容易 需求总在变;什么让大系统难改。 Summary约 300 词 小结 全章回顾。先自己回忆一遍再读它。
先用中文过一遍
先算好存起来:物化和扇出
书里用社交网络的首页时间线来算这笔账。这里换个场景:外卖 app 里有一页「关注」,列出你收藏的店铺最近发的动态(上新、满减)。第一种做法是读的时候现拼:你一打开,就去查你收藏的四十家店各自最近发了什么,按时间归并,取最新的几十条。发动态很便宜,打开页面却要查四十次;在线的人一多、刷得一勤,查询量是「打开次数 × 收藏数」。
第二种做法是写的时候先推:每个用户有一个收件箱,店铺每发一条,就查出收藏它的人,往每个人的收件箱里放一份。打开页面只读自己的收件箱,一次就够。把查询的结果预先算好存起来,叫物化(materialization),收件箱就是一种物化视图。代价挪到了写这边:一条动态要写的份数等于收藏它的人数,一个请求变成多少个下游请求,这个倍数叫扇出(fan-out)。多数店铺收藏的人不多,没问题;碰上几百万人收藏的连锁品牌,发一条就要写几百万次。读 §1.2 时留意书里对两种极端情况的处理为什么不一样。
① 读的时候现拼(拉)
② 写的时候先推(推)
你打开「关注」页
店 1
店 2
……
店 39
店 40
按时间归并,取最新 50 条
每打开一次:查 40 家店
一家店发了一条满减
查出收藏它的 800 人
收件箱
收件箱
……
收件箱
收件箱
每发一条:写 800 个收件箱(扇出 = 800)
打开页面:只读自己的收件箱,一次
混合:几百万人收藏的连锁品牌不推,打开页面时再把它的动态并进收件箱
推还是拉:活在什么时候干、谁来等
本站画的示意图,场景和数字都是编的。真实系统常常两种做法混着用,按发送方的规模分别处理。
响应时间:客户端看到的那个数
描述性能,最常用两个数:吞吐量(每秒处理多少请求)和响应时间(从发出请求到拿到结果)。两者相互牵连:机器越忙,新来的请求越可能要排队,等前面的处理完;吞吐接近机器的上限时,排队时间会急剧变长。
响应时间可以拆开看:请求在网络上走的时间、在服务器上排队的时间、真正被处理的时间(服务时间)、结果传回来的时间。服务端的日志往往只记服务时间。下图三个请求几乎同时到达一台一次只能处理一个请求的服务器:A 碰上了一个慢操作,B 和 C 自己都很快,却只能排在 A 后面。这叫队头阻塞(head-of-line blocking)。服务端的日志说 B 用了 20 毫秒,用户等了 240 毫秒。
一台服务器,一次只处理一个请求;A、B、C 在 0 毫秒同时发出
请求 A
处理(慢操作)200
响应 220 ms
请求 B
排队:等 A 处理完 200
响应 240 ms
请求 C
排队:等 A 和 B 220
响应 260 ms
0
100
200 ms
网络
排队
服务时间(真正在处理)
B、C 的服务时间都只有 20 ms,客户端看到的却是 240、260 ms
本站画的示意图,时间是编的。真实的服务器能并行处理几个请求(受 CPU 核数等限制),但只要慢请求占满了这几个位置,后面的请求一样要等。
看分布,不看平均:百分位和尾巴的放大
同一个请求反复发,每次的响应时间都不一样,所以它是一个分布,不是一个数。把一段时间里的响应时间从快到慢排好,正中间那个是中位数(p50):一半请求比它快。排在 99% 位置的是 p99:一百个请求里只有一个比它慢。p99、p999 这些高百分位叫尾延迟(tail latency)。平均值把少数特别慢的请求摊薄了,看不出有多少人真的等了那么久。
一个请求要调很多后端时,尾巴会被放大。比如一次搜索要并行查 100 个分片,等全部返回才出结果,整次搜索的时间就是最慢那个分片的时间。每个分片只有 1% 的调用慢,100 个分片里至少碰上一个慢的概率却是 1 − 0.99¹⁰⁰,约 63%。下图是这个概率怎么随分片数涨;下面的模拟器可以自己调参数。
0%
25%
50%
75%
100%
1
20
50
100
一次请求要等的分片(后端)个数
每个分片 1% 慢 → 约 63%
每个分片 0.1% 慢 → 约 9.5%
过了这条线,连中位数都是慢的
至少碰上一个慢分片的请求占多少
本站按公式 1 −(1 − p)N 算的曲线,假设各分片慢不慢彼此独立。曲线一越过 1%,整次请求的 p99 就落进了慢的一档;越过 50%,连中位数都慢了。
故障不等于失效
可靠性粗略地说是「出了问题还能正常工作」。书里把「问题」分成两层:系统的某个部件不正常了,叫故障(fault);整个系统不再提供该提供的服务,叫失效(failure)。同一件事,站在不同的层次看法不同:一块盘坏了,对这块盘自己是失效;对一个把数据存了三份的存储系统,只是一个故障。能扛住某些故障、不让它升级成整体失效,叫容错(fault tolerance);扛不住、一坏就全停的那个部件,叫单点故障。
容错的老办法是冗余:多一块盘、多一路电源、多一台机器。冗余管用有一个前提:备份和原件不会一起坏。读 §3.2 时,拿这个前提去对照书里列的硬件故障和软件故障,再看 §3.3 为什么把人为失误放到组织的层面去谈。
这一章点名的系统
HdrHistogram 百分位统计库 书里列的开源百分位估算库之一。按设定的精度记录数值,占的内存只取决于设定的数值范围和精度,不随记录的条数增长。
t-digest 百分位估算算法 书里列的另一个。Ted Dunning 提出,在分布的两端(也就是尾巴上)特别准,分开算的几份摘要可以合并。
DDSketch 百分位估算算法 也在书里的名单上。Datadog 的工程师 2019 年在 VLDB 发表,保证相对误差,可以完全合并。
英文 中文 一句话 nonfunctional requirements 非功能需求 不是「做什么」,而是做得多快、多稳、多好改这类要求(§0)。 fan-out 扇出 一个请求引出多少个下游请求,这个倍数(§1.2)。 materialized view 物化视图 预先算好并随写入更新的查询结果,读快、写贵(§1.2)。 throughput 吞吐量 每秒处理多少请求或多少数据(§2)。 metastable failure 亚稳态失效 过载引发重试,重试加重过载,负载降了系统也回不来(§2)。 response time 响应时间 客户端从发出请求到收到结果的全部时间(§2.1)。 latency 延迟 请求没在被处理的那段时间的统称,比如在网络上走(§2.1)。 head-of-line blocking 队头阻塞 几个慢请求堵在前面,后面快的请求也只能等(§2.1)。 percentile 百分位数 把响应时间排序后某个位置上的值,p50 即中位数(§2.2)。 tail latency 尾延迟 p99、p999 这类高百分位的响应时间(§2.2)。 SLO / SLA 服务水平目标 / 协议 SLO 定目标(如 p99 低于 1 秒),SLA 是没达到时怎么办的合同(§2.3)。 fault / failure 故障 / 失效 一个部件出错,和整个系统不再提供服务(§3)。 fault tolerance 容错 某些故障发生时系统仍然提供服务(§3.1)。 single point of failure (SPOF) 单点故障 它一出故障,整个系统就失效的那个部件(§3.1)。 shared-nothing architecture 无共享架构 多台各有 CPU、内存、磁盘的机器,靠网络协调;也叫横向扩展(§4.2)。
动手:模拟器
先猜:一次搜索并行查 10 个分片,每个分片 1% 的调用要 400 毫秒以上,其余几十毫秒。整次搜索的 p99 是快还是慢?分片加到 100 个,中位数呢?猜好了再选参数验证。
模拟器 扇出与尾延迟 一次搜索并行查 N 个分片,等最慢的那个返回才算完。每次跑 1000 次搜索,看整次搜索的 p50、p99 怎么随分片数和慢请求比例变化。先保持 1%,把分片数从 1 调到 100。
分片数 1 2 5 10 20 50 100
单个分片的慢调用比例 0.1% 1% 2% 5%
换一批 1000 次
重置
慢调用比例 1%,分片数依次选 1、10、100,看「碰上慢分片的搜索」和搜索的 p50、p99。哪一步 p99 先变慢,哪一步连 p50 也慢了?
分片数 100,把慢调用比例降到 0.1%。中位数回来了,p99 呢?要让 100 个分片的搜索 p99 也快,每个分片得在哪个百分位上快?
分片数 1、慢调用比例 1%,连点几次「换一批」,看搜索的 p99 怎么跳。1000 个样本里,决定 p99 的只有最慢的十来个。
词与短语
词条按在书里出现的顺序排,按节分组;读一节之前先把这一节的过一遍,读的时候就不用停。斜体小字是原句里连续的几个词,在电子书里搜它就能找到那一句。标着「每个字都认识」的,是字面意思会把你带偏的。行话(compaction、quorum 这类)不在这里,在上面的术语表里。
§0 If you are building an application…
be driven by
… you will be driven by a list …
由……驱动、跟着……走
这里是说开发工作围着一张需求清单转。
might as well not exist
… or unreliable might as well not exist.
跟不存在没两样
might as well 是「不如、等于」,不是「也许也」。
articulate
… will help you articulate them for …
(把想法)清楚地说出来
动词,不是形容词「口齿伶俐」。说的是把心里默认的要求明确写下来。
§1.1 Representing Users, Posts, and Follows
timely
… Posts are supposed to be timely, …
及时的
不是「定时的」。是说帖子发出后要很快被人看到。
§1.2 Materializing and Updating Timelines
just over
… need to do just over 1 million …
略多于
just 在数字前是「刚刚、稍微」,just over / just under 是「略多于 / 略少于」。
in return
… but in return we have to …
作为交换、代价是
不是「回报」的好意思,这里引出代价:读快了,换来写更费事。
save ourselves the effort
… we can save ourselves the effort of …
省得自己费那个劲
§2 Describing Performance
somethings per second
… measurement is “somethings per second.”
「每秒多少个某某」
作者的小玩笑:把 something 加上复数 s 当单位,意思是什么都可以按每秒来数。
sketch
… service is sketched in Figure 2-3.
(在图里)粗略画出
sketch 是画草图,暗示那张图只示意趋势,不是实测数据。
vicious cycle
… sometimes enter a vicious cycle where …
恶性循环
§2.1 Latency and Response Time
catchall term
… Latency is a catchall term for time …
笼统的统称
catchall 是「什么都往里装的」。作者先承认这个词很宽,再给它划定意思。
latent
… during which it is latent. …
(暂时)搁着、没在被处理
latent 本义「潜伏的」。作者借它的词根解释 latency:请求在那段时间里只是躺着等。
hold up
… slow requests to hold up the processing …
耽搁、拖住
不是「举起」,也不是「撑住」。交通里 held up in traffic 就是堵在路上。
§2.2 Average, Median, and Percentiles
the benefits are diminishing
… and the benefits are diminishing.
收益越来越小(边际收益递减)
diminishing returns 的意思:再往上投入,换回的好处越来越少。
get hold of
… surprisingly difficult to get hold of reliable data …
弄到、拿到手
on closer inspection
… on closer inspection, though, the same …
仔细一看
提示前面的结论要打折扣。
controlling for
… controlling for quality of search results.
排除……的影响(控制变量)
统计用语,不是「控制」搜索质量:比较时把结果质量这个因素固定住,只看快慢的差别。
§2.3 Use of Response Time Metrics
that’s the basic idea, at least
… That’s the basic idea, at least; …
道理大致如此,至少理论上是
作者的保留口吻:后半句马上说实际定义起来没那么简单。
rolling window
… keep a rolling window of response times …
滑动窗口
「最近 10 分钟」这样随时间往前挪的区间,不是「滚动」的意思。
§3.1 Fault Tolerance
escalate to
… in that part escalates to cause …
升级成、扩大为
good luck getting that approved
… good luck getting that budget item approved.
这笔预算你批得下来才怪
反话。字面是「祝你好运」,意思是根本不可能。
exercise
… machinery is continually exercised and tested, …
(让某段机制)真的跑起来、得到演练
熟词生义:代码或机制被 exercised,是说它真的被执行到了,不是「锻炼」。
prevention is better than cure
… where prevention is better than cure …
预防胜于治疗
§3.2 Hardware and Software Faults
more often than we would like
… more often than we would like.
比我们希望的要频繁(其实挺常见)
往轻里说的口吻,要读成「这事并不少见」。
runaway process
… A runaway process that uses up …
失控的进程
runaway 是「脱缰的」,不是「逃跑的」。
lie dormant
… often lie dormant for a long time …
潜伏、一直不发作
dormant 本义休眠,火山、种子都用它。
§3.3 Humans and Reliability
despite best intentions
… to failures, despite best intentions. …
哪怕本意再好
it is tempting to
… It is tempting to label such problems …
人们很容易想要……(但不该)
作者先说这种想法很诱人,下一句就反驳它。读到 tempting 要预期转折。
counterproductive
… blaming people for mistakes is counterproductive.
适得其反
understandably
… many organizations understandably choose features.
可以理解地
作者不是在讽刺,是承认这个选择情有可原,然后把责任从个人挪到组织的优先级上。
rewrite the backend in Haskell
… rewrite the backend in Haskell …
用 Haskell 把后端重写一遍
玩笑:代表另一种过于简单的事故结论,把问题全推给技术栈。
mundane
… more mundane applications are also expected …
平凡的、普通的
little solace
… this is little solace to the people …
算不上什么安慰
cut corners
… when we are cutting corners and keep …
偷工减料、走捷径
字面是抄近道切过拐角,指为省事而省掉该做的步骤。
§4 Scalability
along the lines of
… make comments along the lines of, …
大意是、类似这样的
引出一句大致转述的话,不是原话。
overriding
… the overriding engineering goal is usually …
压倒一切的、首要的
不是编程里「覆盖(override)方法」的意思。
lock you into
… they lock you into an inflexible design …
把你锁死在……上
vendor lock-in 的那个 lock in:进去了就很难出来。
§4.1 Understanding Load
economies of scale
… because of economies of scale or …
规模经济
量越大,单位成本越低。
§4.3 Principles for Scalability
magic scaling sauce
… (informally known as magic scaling sauce). …
(并不存在的)扩展神药
secret sauce 是「秘方」。作者用这个俏皮说法嘲讽「一招通吃」的幻想。
draw the line
… knowing where to draw the line between …
划界、在哪里分开
这里是字面意思往外引申:哪些放在一起、哪些拆开,界线画在哪。
are cool, but
… are cool, but if your load …
挺酷,不过……
先夸一句再泼冷水,作者的典型口吻:好东西不等于你需要。
§5 Maintainability
institutional knowledge
… and institutional knowledge of how and why …
组织里积累下来、往往没写下来的经验
institutional 不是「制度的」,指一个机构里的人脑子里共同知道的东西,人一走就丢了。
intertwined with
… are often intertwined with the human organizations …
和……交织在一起
maintenance headache
… might create maintenance headaches in the future, …
维护上的麻烦事
§5.1 Operability: Making Life Easy for Operations
work around
… can often work around the limitations of …
绕过、变通地应付
workaround 名词是「变通办法」。不是「在周围工作」。
two-edged sword
… automation can be a two-edged sword.
双刃剑
sweet spot
… the sweet spot will depend on …
最合适的那个点、恰到好处的程度
本是球拍上击球最舒服的位置,引申为取舍里最划算的位置。
§5.2 Simplicity: Managing Complexity
mired in
… A software project mired in complexity …
深陷于……
mire 是泥潭,和后面的 mud 呼应。
big ball of mud
… described as a big ball of mud.
一团烂泥(没有结构的代码)
软件圈的固定说法,指什么都缠在一起、看不出架构的系统。
easier said than done
… this is easier said than done.
说起来容易做起来难
§5.3 Evolvability: Making Change Easy
in constant flux
… likely to be in constant flux: …
一直在变
the stakes are higher
… the stakes are much higher than …
风险更大、输不起
stakes 是赌注,不是「木桩」。
到这里先停下,去读原书 下面是读完再看的:你的预测对不对、几道换成你来选的判断题、值得细读的句子和理解检查。先看了,读书时就只是在找答案。
读完:回到你的预测
答案是第三项(§2.3)。整次搜索要等所有分片返回,只要有一个慢,整次就慢;100 个分片全都快的概率是 0.99 的 100 次方,约 37%,所以约 63% 的搜索会慢。书里把这叫尾延迟放大,并没有给这组数字,这是本站按同样的道理算的。慢的搜索超过一半,意味着连中位数都落在 1 秒以上:每个分片的 p99 很好看,整页的 p50 已经不能看了。想一想:每个分片的慢调用降到 0.1%,答案会变成多少?中位数和 p99 各是快还是慢?
答案是第四项(§2.3 的方框)。书里说把百分位取平均在数学上没有意义,正确的合并办法是把各台的直方图加起来再算。原因是百分位看的是排在某个位置的那个值,不是一个能加减的量:整体的 p99 是两台合起来排在 99% 处的那个值,它取决于两台各自的尾巴长什么样。如果第一台最慢的 1% 都只比 100 毫秒多一点,第二台除了最慢的 1% 也都在 100 毫秒以内,整体 p99 接近 100 毫秒;如果它们都是 5 秒,整体 p99 正好是 900 毫秒。所以 900 毫秒只是上限,取平均的 500 毫秒则可能离真值很远。想一想:如果两台的流量相差十倍,只看那台大流量机器的 p99 够不够?
判断题:换成你来选
场景都是本站编的。先选,再看解释;解释里写了对应的节号,拿不准就回原书看那一节。
全员公告该怎么投递?§1.2
场景:一个企业内部的通讯工具,员工打开首屏要看到所订阅频道的最新公告。现在每条公告都写进每个订阅者的收件箱。部门公告一般发给几十人,相安无事;但每次发全员公告(8 万人),投递队列会积压半小时,很多人当天很晚才看到。
全部改成读的时候现拼:打开首屏时查所有订阅的频道 部门公告照旧推;全员公告不推,单独存一份,打开首屏时再并进来 给投递队列加机器,让 8 万份在几秒内写完 全员公告只随机推给一部分人,其余的人看不到也无妨
这正是书里处理粉丝极多的发送方的办法:大扇出的那一类单独存,读的时候合并,其余的照旧推。全改成现拼,每个人每次打开都要查很多频道,读的代价全回来了。加机器能缓解,但要为每周几次的尖峰常备大量资源。丢掉一部分写入,书里只允许用在「关注太多、反正看不完」的读者那一侧,全员公告每个人都必须收到。
看板一切正常,大客户却在投诉,怎么查?§2.2
场景:一个对外的支付接口,监控看板只显示每分钟的平均响应时间,一直稳定在 80 毫秒左右。交易量最大的几家商户却反复投诉「经常卡好几秒」。
平均值稳定说明服务没问题,多半是商户自己的网络 把平均值换成中位数,就能看出问题 把统计间隔从 1 分钟缩到 1 秒,平均值上就会出现尖峰 看 p99、p999,并按商户拆开看:最慢的那一小撮请求可能正落在这几家身上
平均值把少数很慢的请求摊薄了,中位数更是只说典型情况,两者都看不到尾巴。书里举的亚马逊的理由正好对得上:最慢的请求往往来自数据最多的客户,也就是最有价值的客户。缩短统计间隔也许能看到一点波动,但仍然不知道有多少人、哪些人在等。商户网络的说法要在客户端测过才能下结论。
服务为什么恢复不了,先改哪一项?§2
场景:库存服务因为数据库切换卡了 3 分钟。数据库早就好了,库存服务却一直大量超时,直到把它整个重启才恢复。调用它的客户端超时设为 1 秒,超时后立刻重试,最多重试 5 次。
客户端改成指数退避并加随机抖动,连续失败时用熔断器暂停一阵 把客户端超时缩到 200 毫秒,更快发现失败 把重试次数从 5 次加到 10 次,提高成功率 给库存服务加一倍机器,下次就不会过载
这是书里方框讲的重试风暴:卡顿让请求排长队、纷纷超时,立刻重试又把请求量放大好几倍,起因消失了系统仍卡在过载状态(亚稳态失效)。退避、抖动和熔断直接切断这个反馈回路。超时更短、重试更多都只会让风暴更猛。加机器提高了上限,但回路还在,下一次更大的波动照样能把它推进去。
三个可用区为什么一起倒了?§3.2
场景:一个服务在三个可用区各部署 4 台机器,设计目标是扛住整个可用区宕机。某天午夜,全部 12 台同时卡死:服务依赖的一个日期处理库碰到了一个从没测过的日期。
机器太少,扩到 30 台就能扛住 三个可用区离得太近,应该改成跨地域部署 这是相关的软件故障:所有节点跑同一份代码,同一个 bug 同时发作,冗余挡不住;要靠测试、逐步发布、隔离和监控 硬件老化,到了该换机器的时候
冗余的前提是故障彼此独立。硬件故障大体满足这个前提,软件故障恰恰相反:每台机器跑同一份代码,触发条件一到,所有副本一起坏。书里的例子是闰秒和固件在固定运行时长后失效。多加机器、跨地域部署都在复制同一个 bug;硬件老化不会让 12 台在同一秒卡死。
现在要不要为一亿用户做准备?§4 §4.3
场景:一个上线三个月的小型记账 SaaS,日活 3000,一台 PostgreSQL 的负载不到 10%。技术负责人提议现在就拆成 20 个微服务、做分片、上自动扩缩容,理由是「将来到一亿用户也不用改」。
同意:越早做越省事,以后再改代价更大 先别:保持简单好改,盯住负载,在接近下一个数量级前再重新考虑架构 折中:只做分片,不拆微服务 改成按用户自动扩容的无服务器架构,就不用操心扩展
书里的看法:产品还小、需求还在变时,首要目标是简单、灵活;为假想的规模投入,好的情况是白费力气,坏的情况是把你锁死在不灵活的设计里。架构一般只值得提前规划一个数量级。分片和换架构都是在没有瓶颈时提前付复杂度的账;先弄清负载在哪一维增长,才知道该扩哪里。
和本站其他书对照
复杂度到底是什么 APOSD 第 2 章 §5.2 说「简单」没有客观标准。APOSD 那一章给了一个实用的定义:凡是让系统难理解、难修改的东西都算复杂,并归纳出三种症状(改一处要动很多处、要记的东西太多、不知道自己不知道什么)。拿它当尺子,比较 §5.2 里「接口简单还是实现简单」那个问题。
去那一页 → 用冗余扛住坏盘 OSTEP 第 38 章 §3.2 讲硬件冗余,第一个例子就是 RAID。OSTEP 那一章先定好故障模型(盘要么完好、要么整块坏掉且能马上发现),再算镜像、校验各花多少容量、能扛住几块盘坏。读完可以回头想:这一章说的「故障彼此相关」,放到 RAID 上会怎样。
去那一页 →
值得停下来的句子
What we call “human error” is not really the cause of an incident, but rather a symptom of a problem with the sociotechnical system— §3.3。本站译:我们所说的「人为失误」并不真是事故的原因,而是社会技术系统出了问题的症状。
它把追问的方向倒了过来:事故复盘问到「谁按错了按钮」就停,下一次换一个人照样会按错。作者接着把原因落到组织的优先级上(功能和测试二选一时,很多组织选功能),所以 §3.3 的办法几乎都不是技术手段,而是无责复盘、改激励、改投入。这一节让可靠性从硬件和代码延伸到了人。
Scalability is not a one-dimensional label—it is meaningless to say “X is scalable” or “Y doesn’t scale.”— §4。本站译:可扩展性不是一个一维的标签,说「X 可扩展」或「Y 扩展不了」没有意义。
选型争论里常听到「这个库扩展性好」。这句话要求你接着问:沿着哪个方向增长?加什么资源?到哪一步会碰到墙?它也解释了 §4.1 为什么先要把负载描述清楚,负载的形状不同,「能扩展」的意思就不同。
检查一下理解
1.(§1.2)写的时候先推好,为什么读能变快?代价落在哪里? 读的时候不用再查很多来源、再归并,直接取预先算好的结果。代价是每次写都要更新所有相关的结果,写入量按扇出的倍数放大;发送方的受众越大,一次写越贵。
2.(§2)吞吐接近机器的上限时,响应时间为什么急剧变长? 因为排队。机器越忙,新到的请求越可能碰上 CPU 正在处理别的请求,只能等着;接近上限时,等待的时间增长得非常快。
3.(§2.1)为什么要在客户端测响应时间? 排队时间不算在服务时间里。服务端只记自己处理用了多久,看不到请求在队列里等的那一段;几个慢请求堵在前面时,后面的请求处理很快,用户却等了很久。
4.(§2.2)p95 等于 1.5 秒是什么意思?为什么平均值替代不了它? 一百个请求里有 95 个在 1.5 秒以内,5 个要 1.5 秒或更久。平均值是全部加起来再除,少数很慢的请求被摊薄,看不出有多少用户真的等了那么久。
5.(§2.3)一个页面要并行调很多后端,为什么后端的高百分位尤其要紧? 页面要等最慢的那个调用。哪怕每个后端只有很小比例的慢调用,调用的个数一多,至少碰上一个慢调用的概率就大了,慢页面的比例随之上升。
6.(§3)一块硬盘坏了,算故障还是失效? 看站在哪一层。对这块盘自己是失效;如果系统里有别的盘存着副本,对整个系统只是一个故障,系统可以容忍它。只有一块盘的系统,这块盘坏了系统也就失效了。
7.(§3.1)为什么有人故意让进程随机挂掉? 很多严重的 bug 出在错误处理上。故意注入故障,让容错机制经常真的跑起来、被检验,等故障自然发生时才更有把握它能正确处理。
8.(§4.1)什么叫线性扩展?为什么实际成本常常涨得更快? 资源翻倍就能在性能不变的情况下扛住翻倍的负载。实际上常常做不到,原因很多,比如数据多了,同样大小的写请求要做的工作也更多。
用一句话说这一章(写给一个没读过的朋友):
精彩回顾
一句话: 快、稳、能扩展、好维护,都要先说成能测的数字,才能看清代价落在哪里。
活什么时候干 读的时候现拼,还是写的时候先推好:总工作量未必少了,只是挪到了另一头。受众极大的发送方要单独处理。
§1.2 逼近上限,排队暴涨 吞吐接近机器的极限时,响应时间不是慢慢变长,而是陡然变长。过载时立刻重试,会把系统推进回不来的状态。
§2 服务端说 20 毫秒 排队时间不算在服务时间里。几个慢请求堵在前面,后面的快请求在用户那里一样慢,所以响应时间要在客户端量。
§2.1 最慢的是最好的客户 亚马逊按 p999 定内部服务的要求:最慢的请求往往来自数据最多、买得最多的客户。但再往上的 p9999 就不划算了。
§2.2 一个慢,全部慢 并行调 100 个后端,每个 1% 慢,约六成的请求会碰上慢的那个。后端的尾巴,就是页面的身子。
§2.3 同一个 bug 同时发作 硬件故障大体独立,冗余管用;软件故障高度相关,所有节点跑同一份代码,一个条件就能让它们一起倒下。
§3.2 只看一个数量级 能扛住当前负载的架构,多半扛不住十倍。快速增长的服务每涨一个数量级就得重新想,再远的不值得提前规划。
§4.3